[AI] LLM 06
- LLM 06 - Building LLM from scratch
- GPT 처음부터 만들기 — 강의노트
- 10. 연습 문제 및 해답
LLM 06 - Building LLM from scratch
Created: September 2, 2026 3:28 PM Class: LLM Jupyter Notebook: LLM_06.ipynb
GPT 처음부터 만들기 — 강의노트
지금까지의 여정을 정리해보면:
- Attention Is All You Need 논문으로 Transformer의 원리를 배웠고,
LLM_05.ipynb에서 Self-Attention, Multi-Head Attention, Causal Mask, Positional Encoding, Feed-Forward, Residual+LayerNorm, EncoderLayer/Encoder까지 부품 하나하나를 손으로 구현해봤고,- OpenAI GPT 모델과 Ollama의 오픈소스 모델을 가지고 prompt engineering, fine-tuning, RAG을 실습해봤습니다.
이번 노트에서는 그 부품들을 실제로 조립해서, 디코더 전용(decoder-only) GPT 스타일 언어모델을 처음부터 끝까지 만들어보겠습니다.
목표는 거창한 모델이 아니라, “내가 지금까지 API로만 써왔던 그 모델의 안쪽이 정확히 이런 모양이었구나”를 직접 코드로 확인하는 것입니다.
이 강의노트에서 할 일
- Tiny Shakespeare 데이터셋으로 문자 단위(character-level) 토크나이저 만들기
- “다음 문자 예측”이라는 자기지도학습(self-supervised learning) 과제를 위한 배치 만들기
- Attention 없이 임베딩만 쓰는 Bigram 모델을 베이스라인으로 학습시켜 한계를 직접 체감하기
- Causal Self-Attention을 GPT 문맥(미래 토큰 차단)에 맞게 다시 정리하기
- 부품들을 쌓아 완전한 GPT 모델을 조립하기
- 학습 루프를 돌려 실제로 모델을 훈련시키기
- 학습된 모델로 셰익스피어 풍(?) 텍스트를 직접 생성해보기
- 우리가 만든 미니 GPT와 실제 서비스되는 LLM의 차이를 정리하기
이 노트는 Andrej Karpathy의 “Let’s build GPT” 강의와 nanoGPT 저장소의 구조를 참고해서, 처음부터 끝까지 순수 PyTorch 텐서 연산으로 구현합니다.
transformers같은 고수준 라이브러리는 사용하지 않습니다 — 우리가 이미 그 안쪽 구조를 알고 있기 때문입니다.
파이프라인 한눈에 보기
아래는 이 강의노트에서 만들 전체 흐름입니다. 원문 텍스트가 토크나이저 → 임베딩 → Transformer Block(causal self-attention + feed-forward) → 출력 헤드를 거쳐 로짓이 되고, 그 로짓을 학습(loss 계산) 또는 생성(다음 문자 샘플링) 두 가지 방식으로 사용합니다. 아래로 내려가면서 각 단계를 하나씩 직접 구현해봅니다.
원문 텍스트Tiny Shakespeare 코퍼스
토크나이저 (encode)문자 → 정수 인덱스
임베딩토큰 벡터 + 위치 벡터
Transformer Block ×6causal self-attention + FFN
Output headLayerNorm + Linear
Logits다음 문자 확률분포
학습loss → backward → update
생성softmax → sample → decode
↻ 예측 토큰을 이어붙여 반복
0. 필요 라이브러리 설치
이 노트 실습에 필요한 패키지를 설치합니다. 이미 설치되어 있다면 pip가 알아서 건너뜁니다.
torch: 모델 구현 및 학습requests: Tiny Shakespeare 데이터셋 다운로드matplotlib: 학습 손실 곡선 시각화
GPU를 사용하신다면 CUDA에 맞는 PyTorch 빌드가 이미 설치되어 있는지 확인하세요 — 이 셀은 없는 패키지만 채워 넣을 뿐, 기존 GPU 빌드를 CPU 버전으로 덮어쓰지 않습니다.
%pip install -q torch requests matplotlib
1. Setup
먼저 필요한 라이브러리를 불러오고, 실행 장치(device)를 확인합니다.
재현성을 위해 랜덤 시드를 고정합니다 — 시드를 고정해도 GPU 연산의 특성상 완전히 동일한 결과가 나오지 않을 수 있지만, 실행할 때마다 결과가 크게 요동치는 것은 막아줍니다.
import torch
import torch.nn as nn
from torch.nn import functional as F
import matplotlib.pyplot as plt
import matplotlib as mpl

# 재현성을 위한 시드 고정
torch.manual_seed(1337)

# GPU가 있으면 GPU를, 없으면 CPU를 사용
device = 'cuda' if torch.cuda.is_available() else 'cpu'
print(f"사용 장치:{device}")
if device == 'cuda':
    print(f"GPU 이름:{torch.cuda.get_device_name(0)}")

# matplotlib 한글 폰트 설정 (Windows 기본 폰트인 맑은 고딕 사용)
# 폰트를 지정하지 않으면 그래프의 한글 제목/라벨이 네모(□)로 깨져서 표시됨
mpl.rcParams['font.family'] = 'Malgun Gothic'
mpl.rcParams['axes.unicode_minus'] = False  # 맑은 고딕에서 마이너스 기호가 깨지는 문제 방지
실행 결과
사용 장치: cuda
GPU 이름: NVIDIA GeForce RTX 4070
2. 데이터 준비 — Tiny Shakespeare
Tiny Shakespeare는 셰익스피어 작품 전체를 이어붙인 약 1MB짜리 텍스트 파일입니다. Karpathy의 char-rnn 강의 때부터 사용된 고전적인 언어모델 학습용 장난감 데이터셋으로, 구조가 단순해서 “모델이 실제로 무언가를 학습하고 있다”는 것을 눈으로 확인하기 좋습니다.
파일이 로컬에 없으면 다운로드하고, 있으면 그대로 사용합니다.
import os
import requests

data_path = './data/gpt/tinyshakespeare.txt'

if not os.path.exists(data_path):
    url = 'https://raw.githubusercontent.com/karpathy/char-rnn/master/data/tinyshakespeare/input.txt'
    response = requests.get(url)
    response.raise_for_status()
    with open(data_path, 'w', encoding='utf-8') as f:
        f.write(response.text)
    print("데이터셋을 다운로드했습니다.")
else:
    print("이미 다운로드된 데이터셋을 사용합니다.")

with open(data_path, 'r', encoding='utf-8') as f:
    text = f.read()

print(f"전체 글자 수:{len(text):,}")
print("--- 앞부분 미리보기 ---")
print(text[:300])
실행 결과
이미 다운로드된 데이터셋을 사용합니다.
전체 글자 수: 1,115,394
--- 앞부분 미리보기 ---
First Citizen:
Before we proceed any further, hear me speak.

All:
Speak, speak.

First Citizen:
You are all resolved rather to die than to famish?

All:
Resolved. resolved.

First Citizen:
First, you know Caius Marcius is chief enemy to the people.

All:
We know't, we know't.

First Citizen:
Let us
문자 단위(character-level) 토크나이저
실제 GPT 모델들(그리고 우리가 써왔던 OpenAI 모델들)은 BPE(Byte-Pair Encoding) 같은 서브워드 토크나이저를 씁니다. 하지만 이번에는 원리를 가장 단순하게 보기 위해 문자 단위 토크나이저를 직접 만듭니다.
- 장점: 구현이 몇 줄이면 끝나고, vocab 크기가 작아서 (~65개) 학습이 빠릅니다.
- 단점: 같은 문장이라도 BPE보다 토큰 개수가 훨씬 많아지고, 모델이 “단어”라는 개념을 스스로 글자 조합에서 학습해야 합니다.
토크나이저의 본질은 결국 “문자열 ↔︎ 정수 시퀀스”를 왔다갔다 변환하는 매핑일 뿐이라는 것을 이 구현으로 확인할 수 있습니다.
# 텍스트에 등장하는 모든 고유 문자를 정렬된 리스트로 추출
chars = sorted(list(set(text)))
vocab_size = len(chars)

print(f"고유 문자 수 (vocab_size):{vocab_size}")
print(''.join(chars))

# 문자 -> 정수, 정수 -> 문자 매핑 테이블
stoi = {ch: i for i, ch in enumerate(chars)}
itos = {i: ch for i, ch in enumerate(chars)}

def encode(s: str) -> list[int]:
    """문자열을 정수 리스트로 변환"""
    return [stoi[c] for c in s]

def decode(ids: list[int]) -> str:
    """정수 리스트를 문자열로 변환"""
    return ''.join(itos[i] for i in ids)

# 왕복 변환이 잘 되는지 확인
sample = "Hello, world!"
encoded = encode(sample)
print(encoded)
print(decode(encoded))
실행 결과
고유 문자 수 (vocab_size): 65

 !$&',-.3:;?ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz
[20, 43, 50, 50, 53, 6, 1, 61, 53, 56, 50, 42, 2]
Hello, world!
3. 배치 만들기 — “다음 문자 예측” 과제
GPT 계열 모델의 사전학습(pretraining) 과제는 아주 단순합니다: 주어진 문맥(context) 다음에 올 문자를 예측하라.
레이블이 따로 필요 없다는 점에서 이건 자기지도학습(self-supervised learning)입니다 — 텍스트 자체가 곧 정답(다음 글자)을 담고 있기 때문입니다.
먼저 전체 데이터를 정수 텐서로 인코딩하고, train/validation으로 나눕니다.
data = torch.tensor(encode(text), dtype=torch.long)
print(f"인코딩된 전체 데이터 shape:{data.shape}, dtype:{data.dtype}")

n = int(0.9 * len(data))
train_data = data[:n]
val_data = data[n:]

print(f"train:{len(train_data):,}자, val:{len(val_data):,}자")
실행 결과
인코딩된 전체 데이터 shape: torch.Size([1115394]), dtype: torch.int64
train: 1,003,854자, val: 111,540자
block_size: 모델이 한 번에 보는 문맥의 길이
block_size(=context length) 하나의 학습 샘플 안에는 사실 여러 개의 (문맥 → 정답) 쌍이 동시에 들어 있습니다. 예를 들어 block_size=8인 시퀀스 하나에는 문맥 길이 1부터 8까지의 예측 쌍이 전부 포함됩니다. 아래 예시로 확인해봅니다.
block_size_demo = 8
x_demo = train_data[:block_size_demo]
y_demo = train_data[1:block_size_demo+1]  # y는 x보다 한 칸씩 뒤로 밀린 정답

for t in range(block_size_demo):
    context = x_demo[:t+1]
    target = y_demo[t]
    print(f"문맥{context.tolist()} -> 정답{target.item()} ({decode([target.item()])!r})")
실행 결과
문맥 [18] -> 정답 47 ('i')
문맥 [18, 47] -> 정답 56 ('r')
문맥 [18, 47, 56] -> 정답 57 ('s')
문맥 [18, 47, 56, 57] -> 정답 58 ('t')
문맥 [18, 47, 56, 57, 58] -> 정답 1 (' ')
문맥 [18, 47, 56, 57, 58, 1] -> 정답 15 ('C')
문맥 [18, 47, 56, 57, 58, 1, 15] -> 정답 47 ('i')
문맥 [18, 47, 56, 57, 58, 1, 15, 47] -> 정답 58 ('t')
get_batch: 랜덤한 위치에서 미니배치 뽑기
실제 학습에서는 전체 텍스트에서 매번 랜덤한 시작 위치를 여러 개(batch_size개) 뽑아서, 그 위치부터 block_size만큼의 문맥(x)과 한 칸 밀린 정답(y)을 함께 묶어 배치를 만듭니다.
x, y를 만드는 방식이 위 데모와 완전히 같다는 점에 주목하세요 — 배치 처리를 위해 여러 개를 한 번에 뽑을 뿐입니다.
block_size = 256  # 모델이 한 번에 보는 문맥 길이
batch_size = 64    # 한 스텝에 동시에 처리하는 시퀀스 개수

def get_batch(split: str):
    d = train_data if split == 'train' else val_data
    # 배치 크기만큼 랜덤한 시작 위치를 뽑는다
    ix = torch.randint(len(d) - block_size, (batch_size,))
    x = torch.stack([d[i:i+block_size] for i in ix])
    y = torch.stack([d[i+1:i+block_size+1] for i in ix])
    return x.to(device), y.to(device)

xb, yb = get_batch('train')
print(f"입력 배치 shape:{xb.shape}")   # (batch_size, block_size)
print(f"정답 배치 shape:{yb.shape}")
실행 결과
입력 배치 shape: torch.Size([64, 256])
정답 배치 shape: torch.Size([64, 256])
4. 베이스라인: Bigram 언어모델
본격적으로 Attention을 쓰기 전에, 가장 단순한 베이스라인부터 만들어봅니다.
Bigram 모델은 바로 직전 문자 하나만 보고 다음 문자를 예측합니다 — 즉 문맥을 전혀 활용하지 않습니다. 임베딩 테이블 하나가 사실상 “이 문자 다음에는 이런 문자들이 이런 확률로 온다”는 표를 직접 학습하는 것과 같습니다.
이 모델을 먼저 학습시켜서 결과를 본 다음, 나중에 Attention을 추가한 진짜 GPT와 비교하면 Attention이 왜 필요한지 훨씬 체감이 잘 됩니다.
먼저 학습/평가 전체에서 재사용할 손실(loss) 측정 함수를 하나 정의해둡니다. 배치 하나의 loss는 노이즈가 커서, 여러 배치의 평균을 내서 좀 더 안정적인 값을 봅니다.
eval_iters = 200

@torch.no_grad()
def estimate_loss(model):
    """train/val 각각에서 여러 배치를 뽑아 평균 loss를 계산 (노이즈 감소용)"""
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            _, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean().item()
    model.train()
    return out
class BigramLanguageModel(nn.Module):
    def __init__(self, vocab_size):
        super().__init__()
        # (vocab_size, vocab_size) 테이블: 각 문자가 다음 문자에 대한 로짓을 직접 담고 있음
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):
        logits = self.token_embedding_table(idx)  # (B, T, vocab_size)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            logits, _ = self(idx)
            logits = logits[:, -1, :]  # 마지막 타임스텝의 로짓만 사용
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)  # 확률적으로 다음 토큰 샘플링
            idx = torch.cat((idx, idx_next), dim=1)
        return idx

bigram_model = BigramLanguageModel(vocab_size).to(device)

# 학습 전 loss는 이론상 -ln(1/vocab_size)에 가까워야 함 (완전 랜덤 예측)
import math
print(f"이론적 초기 loss (완전 랜덤):{math.log(vocab_size):.4f}")
losses = estimate_loss(bigram_model)
print(f"실제 초기 loss: train{losses['train']:.4f}, val{losses['val']:.4f}")
실행 결과
이론적 초기 loss (완전 랜덤): 4.1744
실제 초기 loss: train 4.7524, val 4.7588
# Bigram 모델을 짧게 학습
optimizer = torch.optim.AdamW(bigram_model.parameters(), lr=1e-3)

for step in range(3000):
    xb, yb = get_batch('train')
    logits, loss = bigram_model(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

losses = estimate_loss(bigram_model)
print(f"학습 후 loss: train{losses['train']:.4f}, val{losses['val']:.4f}")
실행 결과: 학습 후 loss: train 2.6453, val 2.6654
# Bigram 모델로 텍스트 생성
context = torch.zeros((1, 1), dtype=torch.long, device=device)
generated = bigram_model.generate(context, max_new_tokens=300)[0].tolist()
print(decode(generated))
실행 결과
And;xfDkRZkidcowindT, s b, btK

Hiret bubeAUM:
WS:BO-3DSA:

gatanhXFYon thainuwqhathG.t?
F dXENDoate awice my.
WfDYZaYomzo muX
Yow&$
METf it h bl&VO$w;
IY:
ARKes ireeY?
BEcin lat Heriliov tsSe,Bend l nghir.
SWjus!
elJlind me l.
MIsh3qce wiry:
Supr aisspllw y. JurBESSI yBoopeYelavIENVomy.y wod motS?
결과를 보면 loss는 확실히 낮아졌지만(랜덤 수준인 ~4.17에서 ~2.5 근방으로), 생성된 텍스트는 여전히 단어도 아니고 문법도 없는 알아볼 수 없는 나열입니다.
바로 직전 문자 하나만 보고 다음 문자를 정해야 하니, 단어나 문장 구조 같은 긴 문맥 의존성을 전혀 포착할 수 없기 때문입니다. 이제 이 한계를 Self-Attention으로 풀어봅니다.
5. Causal Self-Attention — GPT 문맥으로 다시 정리하기
LLM_05.md에서 이미 Self-Attention의 원리(Query/Key/Value, Scaled Dot-Product, Multi-Head)를 구현해봤습니다. 여기서는 그 구조를 GPT(디코더 전용) 문맥에 맞게 다시 정리합니다.
핵심 차이는 하나입니다: 인코더의 Self-Attention은 모든 위치가 서로를 볼 수 있지만, GPT의 Self-Attention은 각 위치가 자기 자신과 그 이전 위치만 볼 수 있어야 합니다. 그래야 “다음 문자 예측”이라는 학습 과제가 답을 미리 훔쳐보지 않는 정당한 문제가 됩니다. 이를 위해 하삼각 마스크(causal mask)로 미래 위치의 attention score를 -inf로 막아버립니다.
먼저 이후에 쓸 하이퍼파라미터들을 한곳에 정리합니다.
# 모델 하이퍼파라미터 (nanoGPT의 소형 설정을 따름 — GPU에서 수 분 내 학습 가능)
n_embd = 384    # 임베딩 차원
n_head = 6      # attention head 개수
n_layer = 6     # Transformer 블록(레이어) 개수
dropout = 0.2   # 과적합 방지용 dropout 비율

print(f"head 하나의 차원 (n_embd // n_head):{n_embd // n_head}")
실행 결과: head 하나의 차원 (n_embd // n_head): 64
class Head(nn.Module):
    """Self-Attention head 하나"""

    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        # 학습되지 않는 버퍼로 등록 (미래 위치를 가리는 하삼각 마스크)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)    # (B, T, head_size)
        q = self.query(x)  # (B, T, head_size)

        # Scaled Dot-Product Attention: q와 k의 내적을 head_size의 제곱근으로 나눠 스케일 조정
        wei = q @ k.transpose(-2, -1) * (C ** -0.5)  # (B, T, T)

        # Causal mask: 미래 위치(대각선 위쪽)는 -inf로 막아 softmax 이후 0이 되게 함
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)
        wei = self.dropout(wei)

        v = self.value(x)
        out = wei @ v  # (B, T, head_size)
        return out

class MultiHeadAttention(nn.Module):
    """여러 head를 병렬로 실행하고 결과를 이어붙인 뒤 다시 선형 변환"""

    def __init__(self, num_heads, head_size):
        super().__init__()
        self.heads = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embd, n_embd)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        out = torch.cat([h(x) for h in self.heads], dim=-1)  # (B, T, n_embd)
        out = self.dropout(self.proj(out))
        return out
여러 head로 나누는 이유는 LLM_05에서 다룬 것과 동일합니다 — 하나의 head가 “전체적으로 비슷한” attention 패턴 하나만 학습하는 대신, 여러 head가 각자 다른 종류의 관계(예: 문법적 관계, 인접 문자 관계 등)에 특화되도록 여지를 주기 위함입니다.
6. 부품 조립하기 — Feed-Forward, Block, 그리고 완전한 GPT
이제 남은 부품은 두 가지입니다.
- Feed-Forward Network: attention이 “토큰들 사이의 관계”를 계산하는 역할이라면, FFN은 각 위치마다 독립적으로 “계산(생각)”을 하는 역할입니다.
LLM_05의 Position-wise FFN과 동일한 구조입니다. - Block: attention과 FFN을 Residual 연결 + LayerNorm으로 감싸서 하나의 단위로 묶은 것. 이 Block을 여러 겹 쌓는 것이 곧 “모델을 깊게 만든다”는 의미입니다.
여기서는 Pre-LayerNorm 방식(LayerNorm을 attention/FFN에 들어가기 전에 적용)을 씁니다. GPT-2 이후 실제 모델들이 이 방식을 채택한 이유는, 레이어가 깊어져도 학습이 안정적이기 때문입니다.
class FeedForward(nn.Module):
    """토큰별로 독립적으로 적용되는 간단한 MLP"""

    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
            nn.Dropout(dropout),
        )

    def forward(self, x):
        return self.net(x)

class Block(nn.Module):
    """Transformer 디코더 블록: 통신(Self-Attention) + 계산(FeedForward)"""

    def __init__(self, n_embd, n_head):
        super().__init__()
        head_size = n_embd // n_head
        self.sa = MultiHeadAttention(n_head, head_size)
        self.ffwd = FeedForward(n_embd)
        self.ln1 = nn.LayerNorm(n_embd)
        self.ln2 = nn.LayerNorm(n_embd)

    def forward(self, x):
        # Pre-LN + Residual: 입력을 LayerNorm 통과시킨 뒤 서브레이어에 넣고, 원래 입력에 더해준다
        x = x + self.sa(self.ln1(x))
        x = x + self.ffwd(self.ln2(x))
        return x
전체 GPT 모델
마지막으로 다음 요소들을 합쳐 완전한 모델을 만듭니다.
- 토큰 임베딩: 각 문자를
n_embd차원 벡터로 변환 - 위치 임베딩: 같은 문자라도 문장에서 몇 번째 위치인지에 따라 다른 정보를 더해줌 (
LLM_05의 Positional Encoding과 목적은 같지만, 여기서는 사인/코사인 고정 함수 대신 학습되는 임베딩 테이블을 씁니다 — GPT-2 방식) - Block을
n_layer개 쌓기 - 최종 LayerNorm + Linear(lm_head): 마지막에 vocab_size 차원으로 투영해서 각 문자에 대한 로짓을 뽑음
class GPTLanguageModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.position_embedding_table = nn.Embedding(block_size, n_embd)
        self.blocks = nn.Sequential(*[Block(n_embd, n_head) for _ in range(n_layer)])
        self.ln_f = nn.LayerNorm(n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape

        tok_emb = self.token_embedding_table(idx)                          # (B, T, n_embd)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device))  # (T, n_embd)
        x = tok_emb + pos_emb   # 브로드캐스팅으로 (B, T, n_embd)
        x = self.blocks(x)
        x = self.ln_f(x)
        logits = self.lm_head(x)  # (B, T, vocab_size)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    @torch.no_grad()
    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            # position embedding 테이블 크기(block_size)를 넘지 않도록 최근 문맥만 사용
            idx_cond = idx[:, -block_size:]
            logits, _ = self(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim=1)
        return idx

model = GPTLanguageModel().to(device)
n_params = sum(p.numel() for p in model.parameters())
print(f"모델 파라미터 수:{n_params/1e6:.2f}M")
실행 결과: 모델 파라미터 수: 10.79M
7. 학습 루프
Bigram 모델과 학습 방식 자체는 동일합니다 — AdamW 옵티마이저로 cross-entropy loss를 줄여나갑니다. 차이는 모델 구조뿐입니다.
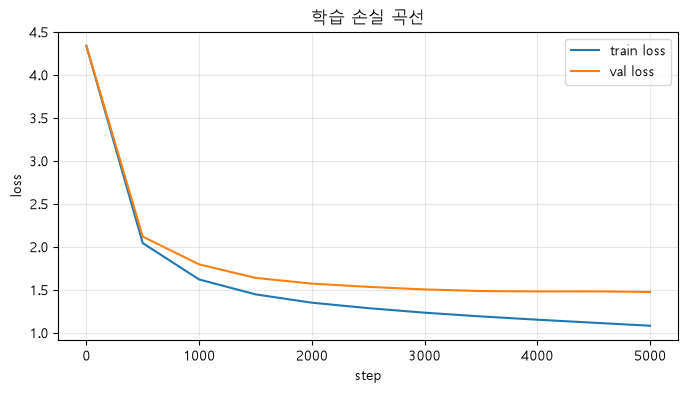
eval_interval마다 estimate_loss로 train/val loss를 확인해서, 학습이 잘 진행되고 있는지 + overfitting은 없는지 함께 관찰합니다.
GPU 기준 약 5,000 step이면 몇 분 내로 끝납니다. 더 빨리 결과만 보고 싶다면
max_iters를 줄여도 되고, 결과를 더 다듬고 싶다면 늘려도 됩니다.
learning_rate = 3e-4
max_iters = 5000
eval_interval = 500

optimizer = torch.optim.AdamW(model.parameters(), lr=learning_rate)

train_losses, val_losses, logged_steps = [], [], []

for step in range(max_iters):
    if step % eval_interval == 0 or step == max_iters - 1:
        losses = estimate_loss(model)
        print(f"step{step:5d}: train loss{losses['train']:.4f}, val loss{losses['val']:.4f}")
        train_losses.append(losses['train'])
        val_losses.append(losses['val'])
        logged_steps.append(step)

    xb, yb = get_batch('train')
    logits, loss = model(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
실행 결과 (실제 GPU 학습 로그)
step     0: train loss 4.3371, val loss 4.3377
step   500: train loss 2.0410, val loss 2.1171
step  1000: train loss 1.6180, val loss 1.7937
step  1500: train loss 1.4449, val loss 1.6365
step  2000: train loss 1.3475, val loss 1.5699
step  2500: train loss 1.2842, val loss 1.5320
step  3000: train loss 1.2315, val loss 1.5022
step  3500: train loss 1.1879, val loss 1.4832
step  4000: train loss 1.1499, val loss 1.4785
step  4500: train loss 1.1147, val loss 1.4794
step  4999: train loss 1.0798, val loss 1.4727
plt.figure(figsize=(8, 4))
plt.plot(logged_steps, train_losses, label='train loss')
plt.plot(logged_steps, val_losses, label='val loss')
plt.xlabel('step')
plt.ylabel('loss')
plt.title('학습 손실 곡선')
plt.legend()
plt.grid(alpha=0.3)
plt.show()
학습 손실 곡선
학습 손실 곡선
val loss가 train loss와 크게 벌어지지 않고 함께 내려간다면, 데이터 규모 대비 모델이 심하게 overfitting되지 않고 있다는 신호입니다. (참고: Karpathy의 원 강의 설정 기준으로 최종 val loss는 대략 1.4~1.5 부근까지 내려갑니다 — 위 결과의 최종 val loss 1.4727과 거의 일치합니다.)
8. 학습된 모델로 텍스트 생성하기
이제 학습된 GPT로 텍스트를 생성해봅니다. 시작 토큰으로 빈 문맥(줄바꿈 문자 하나)을 주고, generate 함수가 한 글자씩 자기회귀적(autoregressive)으로 다음 글자를 샘플링하며 이어붙입니다.
Bigram 모델의 결과와 비교해보세요 — 완벽한 셰익스피어는 아니지만, 인물 이름, 대사 형식(이름: 대사), 문장 부호, 단어 비슷한 패턴이 나타나기 시작하는 것을 볼 수 있습니다. 이게 바로 Self-Attention이 문맥을 실제로 활용하고 있다는 증거입니다.
context = torch.zeros((1, 1), dtype=torch.long, device=device)
generated = model.generate(context, max_new_tokens=500)[0].tolist()
print(decode(generated))
실행 결과
Save the hate great Rutland: but, that we resign.
Nay, bear the Turrk. How news he shall be barred?
That bow he hath now aught such days not some alone
I', I long by conquest my comfort's chard?
We pay, madam?

NORTHUMBERLAND:
What shall be myself? sirre gone, stone be changed,
Hold-footing and will not out of the crown?
I'll want whole axe, we have got rotten thee,
and charged the foe in drew asleeper and men.
And, this young scent I go ro; she shall all be
Mire in the close's rest, immorself,
임의의 시작 문장으로 이어쓰기
특정 문장 뒤를 이어 쓰게 만들 수도 있습니다 — 문맥을 인코딩해서 초기 idx로 넣어주기만 하면 됩니다.
prompt = "ROMEO:"
context = torch.tensor([encode(prompt)], dtype=torch.long, device=device)
generated = model.generate(context, max_new_tokens=300)[0].tolist()
print(decode(generated))
실행 결과
ROMEO:
Well, thou shalt fetch it with the rest; and
With all those that torn will break my mistress
Of glot our doom: but therefore, my lord.

WARWICK:
Then being breathe, for are their English tender,
And Momertakies time in my mind be day's;
And, it knows then dear lady sail, 'bones pardonable!'
We hath
ROMEO:라는 프롬프트를 그대로 유지한 채, 곧바로 인물 이름과 대사 형식(WARWICK: 같은 패턴)이 이어지는 걸 볼 수 있습니다 — Bigram 모델의 결과(섹션 4)와 나란히 비교하면 차이가 뚜렷합니다.
9. 마무리 — 우리가 만든 것과 실제 LLM의 차이
지금까지 만든 모델은 대략 10M 파라미터 규모의, 문자 단위 GPT입니다. 이걸 그동안 API로 써온 GPT-4나 Ollama의 오픈소스 모델들과 비교하면 원리는 완전히 같지만, 다음 지점들에서 차이가 납니다.
| 구분 | 우리가 만든 모델 | 실제 서비스되는 LLM |
|---|---|---|
| 토크나이저 | 문자 단위 (vocab_size ≈ 65) | BPE/SentencePiece 등 서브워드 (vocab_size 수만~수십만) |
| 파라미터 수 | ~10M | 수십억~수조 |
| 학습 데이터 | 텍스트 1개 파일 (~1MB) | 웹 전체 규모의 코퍼스 (TB 단위) |
| 학습 목표 | 다음 문자 예측 (pretraining만) | pretraining + instruction tuning + RLHF/DPO 등 |
| 결과물 | “이어쓰기”만 잘하는 모델 | 지시를 따르고 대화하는 “챗” 모델 |
중요한 포인트: 우리가 만든 모델이 “지시를 따르지 않고 그냥 텍스트를 이어쓰기만 하는” 이유는 모델이 작아서가 아니라, 애초에 그렇게만 학습시켰기 때문입니다. 여러분이 이미 실습해본 fine-tuning(LoRA 등)이 바로 이 지점 — pretrained 모델을 특정 목적에 맞게 추가 학습시키는 단계 — 을 담당합니다. 즉:
- 오늘 만든 것: pretraining 단계 (다음 토큰 예측)
- 이미 해보신 것: 그 위에 fine-tuning으로 특정 태스크에 맞추기, RAG로 외부 지식 주입하기, 프롬프트로 행동 유도하기
이 노트에서 만든 모델도 원리상 이 모든 실습의 대상이 될 수 있습니다 — 다만 규모가 작아서 결과가 인상적이지 않을 뿐입니다.
10. 연습 문제 및 해답
아래는 5개 연습 문제와 실제 풀이 코드, 실행 결과입니다. 정답이 하나만 있는 건 아니니, 참고하되 직접 값을 바꿔가며 실험해보시길 권장합니다.
아래 셀들은 위에서 학습한
model,get_batch,estimate_loss등을 그대로 재사용합니다. 순서대로(위에서 아래로) 실행해야 합니다.
연습 1 — n_layer, n_head, n_embd를 바꿔가며 비교
전체 5,000 step을 여러 설정으로 반복하면 너무 오래 걸리므로, 빠른 비교를 위해 학습 반복 횟수를 줄여서(iters=1500) 실행합니다. 절대적인 loss 값보다는 설정 간의 상대적인 차이에 집중하는 것이 목적입니다.
# 연습 1: 하이퍼파라미터별 파라미터 수 / val loss 비교
def build_and_train(n_layer_, n_head_, n_embd_, iters=1500):
    """주어진 하이퍼파라미터로 새 모델을 만들고 짧게 학습시킨 뒤 (파라미터 수, val loss)를 반환"""
    global n_layer, n_head, n_embd  # Head/Block/GPTLanguageModel의 __init__이 참조하는 전역 변수를 임시로 덮어씀
    n_layer, n_head, n_embd = n_layer_, n_head_, n_embd_

    m = GPTLanguageModel().to(device)
    n_params = sum(p.numel() for p in m.parameters())

    opt = torch.optim.AdamW(m.parameters(), lr=learning_rate)
    for step in range(iters):
        xb, yb = get_batch('train')
        _, loss = m(xb, yb)
        opt.zero_grad(set_to_none=True)
        loss.backward()
        opt.step()

    val_loss = estimate_loss(m)['val']
    return n_params, val_loss

# (n_layer, n_head, n_embd) 조합 3가지를 비교 — head_size(=n_embd//n_head)가 정수가 되도록 선택
configs = [
    (2, 2, 128),   # 작은 모델
    (6, 6, 384),   # 노트북 본문과 동일한 기본 설정
    (8, 8, 512),   # 더 큰 모델
]

for nl, nh, ne in configs:
    n_params, val_loss = build_and_train(nl, nh, ne)
    print(f"n_layer={nl}, n_head={nh}, n_embd={ne} -> 파라미터{n_params/1e6:.2f}M, val loss{val_loss:.4f}")

# 전역 하이퍼파라미터를 원래 값으로 복원 (이후 셀에서 model 변수를 다시 쓸 때 혼동을 피하기 위함)
n_layer, n_head, n_embd = 6, 6, 384
실행 결과
n_layer=2, n_head=2, n_embd=128 -> 파라미터 0.45M, val loss 2.1715
n_layer=6, n_head=6, n_embd=384 -> 파라미터 10.79M, val loss 1.6404
n_layer=8, n_head=8, n_embd=512 -> 파라미터 25.41M, val loss 1.5870
모델을 25.41M(약 2.4배)까지 키워도 val loss는 1.64 → 1.59로 소폭만 개선됩니다 — 이 정도 규모의 데이터(1.1MB)로는 모델을 무작정 키운다고 성능이 비례해서 좋아지지 않는다는 것을 보여줍니다. 데이터 규모와 모델 규모가 함께 늘어나야 한다는 스케일링 법칙의 축소판을 여기서도 확인할 수 있습니다.
연습 2 — generate에 temperature 추가
temperature로 softmax에 들어가기 전 로짓을 나눠서 확률 분포의 뾰족한 정도를 조절합니다. 낮을수록(예: 0.3) 확률이 높은 문자에 더 집중해 보수적이고 반복적인 텍스트가, 높을수록(예: 1.5) 다양하지만 무작위한 텍스트가 나옵니다.
# 연습 2: temperature를 조절할 수 있는 generate 함수
@torch.no_grad()
def generate_with_temperature(m, idx, max_new_tokens, temperature=1.0):
    for _ in range(max_new_tokens):
        idx_cond = idx[:, -block_size:]
        logits, _ = m(idx_cond)
        logits = logits[:, -1, :] / temperature  # temperature로 나눠 분포의 뾰족함(sharpness)을 조절
        probs = F.softmax(logits, dim=-1)
        idx_next = torch.multinomial(probs, num_samples=1)
        idx = torch.cat((idx, idx_next), dim=1)
    return idx

context = torch.zeros((1, 1), dtype=torch.long, device=device)

for temp in [0.3, 1.0, 1.5]:
    print(f"--- temperature={temp} ---")
    out = generate_with_temperature(model, context, max_new_tokens=200, temperature=temp)
    print(decode(out[0].tolist()))
    print()
실행 결과
--- temperature=0.3 ---

Lord Angelo.

CAMILLO:
I do beseech you, sir, I have seen a man
a pardon to say a man to do that you are.

CAMILLO:
I have been a man in the same of mine own intent,
and more than a most controver th

--- temperature=1.0 ---

JULIET:
My prince is, yet bleed.

Nurse:
Why stit! Was you a fool?

Second Murderer:
Protest: you must not but thine!
Good morrow, my lord, I have struck us talk.

Norborn more.
Farewell:

KING RICHAR

--- temperature=1.5 ---

JUve's she; yea, all's, might my mausts; and black York
mish'dst with whoesome!

JULIEY:
Know, aith, 'tis coap: hither maidds;' all't trifles.

GLOUCESTER:
You end thken choice with of misreadas. Then
temperature=0.3에서는 “CAMILLO”라는 이름이 반복 등장할 만큼 보수적이고 반복적인 반면, temperature=1.5에서는 JUve's, mausts처럼 실제 단어가 아닌 조합이 늘어나며 다양성은 커지지만 문법이 더 자주 무너집니다.
연습 3 — dropout=0으로 overfitting 비교
dropout을 0으로 낮추면 정규화(regularization) 효과가 사라지므로, train loss는 더 낮아지지만 val loss와의 격차(=overfitting 정도)는 커지는 경향을 보입니다. 연습 1과 마찬가지로 빠른 비교를 위해 학습 반복 횟수를 줄였습니다.
# 연습 3: dropout 값에 따른 train/val loss 격차 비교
def train_with_dropout(dropout_value, iters=1500):
    global dropout  # Head/MultiHeadAttention/FeedForward가 참조하는 전역 dropout 값을 변경
    dropout = dropout_value

    m = GPTLanguageModel().to(device)
    opt = torch.optim.AdamW(m.parameters(), lr=learning_rate)
    for step in range(iters):
        xb, yb = get_batch('train')
        _, loss = m(xb, yb)
        opt.zero_grad(set_to_none=True)
        loss.backward()
        opt.step()

    losses = estimate_loss(m)
    return losses['train'], losses['val']

for d in [0.2, 0.0]:
    train_loss, val_loss = train_with_dropout(d)
    gap = val_loss - train_loss
    print(f"dropout={d}: train{train_loss:.4f}, val{val_loss:.4f}, 격차(val-train){gap:.4f}")

dropout = 0.2  # 원래 값으로 복원
실행 결과
dropout=0.2: train 1.4380, val 1.6401, 격차(val-train) 0.2021
dropout=0.0: train 1.3884, val 1.6171, 격차(val-train) 0.2287
dropout=0.0으로 낮추면 train loss는 더 내려가지만(1.4380 → 1.3884), 격차는 오히려 0.2021 → 0.2287로 커집니다 — dropout이 실제로 overfitting을 억제하는 정규화 역할을 하고 있음을 숫자로 확인할 수 있습니다.
연습 4 — 문자 단위 vs BPE(tiktoken) 토크나이저 비교
GPT-2가 실제로 쓰는 BPE 토크나이저(tiktoken)로 같은 텍스트를 인코딩해서, 문자 단위 토크나이저와 토큰 개수를 비교합니다. 같은 block_size라도 BPE 쪽이 훨씬 더 많은 원문을 담을 수 있다는 것을 확인할 수 있습니다.
%pip install -q tiktoken
# 연습 4: 문자 단위 토크나이저 vs BPE 토크나이저 비교
import tiktoken

enc = tiktoken.get_encoding("gpt2")  # 실제 GPT-2가 사용하는 BPE 토크나이저

sample_text = text[:1000]  # 앞부분 1000자로 비교

char_tokens = encode(sample_text)     # 우리가 만든 문자 단위 토크나이저
bpe_tokens = enc.encode(sample_text)  # GPT-2의 BPE 토크나이저

print(f"원문 글자 수:{len(sample_text)}")
print(f"문자 단위 토큰 수:{len(char_tokens)} (vocab_size={vocab_size})")
print(f"BPE 토큰 수:{len(bpe_tokens)} (vocab_size={enc.n_vocab:,})")
print(f"같은 block_size={block_size} 안에 BPE는 문자 단위보다 약 "
      f"{len(char_tokens) / len(bpe_tokens):.1f}배 더 많은 원문을 담을 수 있음")
실행 결과
원문 글자 수: 1000
문자 단위 토큰 수: 1000 (vocab_size=65)
BPE 토큰 수: 285 (vocab_size=50,257)
같은 block_size=256 안에 BPE는 문자 단위보다 약 3.5배 더 많은 원문을 담을 수 있음
문자 1,000개가 문자 단위 토크나이저로는 1,000토큰인데, BPE로는 285토큰까지 압축됩니다 — 자주 나오는 문자 조합(“the”, “ing” 등)을 하나의 토큰으로 묶기 때문입니다. 같은 block_size=256이라면 BPE 모델이 훨씬 더 긴 문맥을 한 번에 볼 수 있다는 뜻입니다.
연습 5 — 모델 저장 후 LoRA로 파인튜닝
먼저 학습된 GPTLanguageModel을 저장합니다. 그다음 이미 실습해본 peft 라이브러리의 LoRA를 우리 모델에 그대로 적용해봅니다 — attention의 query, value projection(Head 클래스 안의 nn.Linear)에만 저랭크 어댑터를 붙이는 방식입니다.
# 연습 5-1: 학습된 모델 저장
torch.save(model.state_dict(), './model/gpt_scratch.pt')
print("모델 저장 완료: gpt_scratch.pt")
실행 결과: 모델 저장 완료: gpt_scratch.pt
%pip install peft tqdm
# 연습 5-2: peft로 LoRA 적용
from peft import LoraConfig, get_peft_model

lora_config = LoraConfig(
    r=8,                                 # 저랭크(low-rank) 차원 — 클수록 표현력은 늘지만 파라미터도 늘어남
    lora_alpha=16,                       # LoRA 출력 스케일링 계수 (보통 r의 2배 정도로 설정)
    target_modules=["query", "value"],   # Head 클래스 안의 query/value Linear 레이어에만 적용
    lora_dropout=0.05,
)

lora_model = get_peft_model(model, lora_config)
lora_model.print_trainable_parameters()  # 전체 파라미터 대비 학습 대상(LoRA) 파라미터 비율 확인

# 이후 특정 스타일의 소량 텍스트로 섹션 7의 학습 루프를 다시 돌리면,
# 원본 파라미터는 얼어붙은(freeze) 채 LoRA 어댑터만 업데이트되어 훨씬 적은 자원으로 파인튜닝할 수 있다.
실행 결과
trainable params: 258,048 || all params: 11,046,977 || trainable%: 2.3359
전체 11,046,977개 파라미터 중 학습 대상은 258,048개(2.34%)뿐입니다. 나머지 97.66%는 pretraining 때 학습한 값 그대로 얼어붙어 있고, LoRA 어댑터만 업데이트됩니다 — 훨씬 적은 자원으로 특정 스타일에 맞게 파인튜닝할 수 있는 이유가 바로 이것입니다.
참고자료
- Vaswani et al., 2017, Attention Is All You Need
- Andrej Karpathy, “Let’s build GPT: from scratch, in code, spelled out” (YouTube)
- Andrej Karpathy, nanoGPT (GitHub)
- Andrej Karpathy, char-rnn tinyshakespeare 데이터셋