[AI] LLM 05
- LLM 05 - Self-Attention
- Self-Attention \& Transformer 강의노트
- Part 1. Self-Attention 핵심 메커니즘
- 1. Attention이 왜 등장했나 (Encoder-Decoder Attention 배경)
- 2. Self-Attention이란 (Query, Key, Value)
- 3. NumPy로 일반화해서 구현해보기
- 4. Attention Weight 시각화
- 5. 왜 대각선이 항상 크지는 않은가 (Q=K인 경우와 비교)
- 6. PyTorch로 재구현 (nn.Module)
- 7. Multi-Head Attention
- 8. Causal Mask (디코더용 마스킹)
- 9. 실전 예제: 문장에 Self-Attention 적용해보기
- 10. Self-Attention 실제로 학습시켜보기
- Part 2. 논문의 나머지 부분 채우기
- 11. Positional Encoding — 순서 정보 주입하기
- 12. Position-wise Feed-Forward Network
- 13. Residual Connection과 Layer Normalization
- 14. 하나로 합치기: EncoderLayer와 Encoder
- 15. Decoder 구조 맛보기
- 16. Embedding 스케일링과 Weight Tying
- 17. Self-Attention을 쓰는 이유 (계산 복잡도 비교)
- 18. 논문처럼 학습 레시피 제대로 따라하기
- 19. 실험 결과와 우리가 재현하지 않는 이유
- 20. 진짜로 학습된 모델은 무엇에 주목할까
- 21. 캡스톤: Positional Encoding까지 포함한 완전한 Encoder
- 연습 문제 및 해설
- 연습 1.
seq_len을 8개로 늘려서 실행하면? - 연습 2.
√d_k로 나누지 않으면? - 연습 3~4.
num_heads를 1, 4, 8로 바꿔보면? - 연습 5. Causal mask 유무에 따른 마지막 토큰의 attention
- 연습 6. RAG와 연결짓기 — Cross-Attention으로 확장
- 연습 7.
num_epochs/lr을 바꾸면 수렴 속도가 어떻게 달라질까 - 연습 8. PE 유무에 따라 “학습된 모델”의 순서 민감도가 달라질까
- 연습 9.
num_layers를 2 → 4 → 6으로 늘리면 파라미터 수는? - 연습 10.
warmup_steps를 5, 50, 200으로 바꾸면? - 연습 11. Label Smoothing 유무 비교
- 연습 12. Cross-Attention에 다른 원문을 넣으면?
- 연습 1.
- 참고자료
LLM 05 - Self-Attention
Created: September 2, 2026 11:16 AM Class: LLM Jupyter Notebook: LLM_05.ipynb
Self-Attention & Transformer 강의노트
RAG까지 배운 내용을 이어서, Transformer의 핵심 메커니즘인 Self-Attention을 직접 손으로 구현하며 이해합니다.
이 강의노트에서 다루는 것:
- Attention이 왜 등장했는지 배경부터 짚고 시작하기
- NumPy로 수식을 그대로 계산해보기
- 결과를 시각화해서 “어떤 토큰이 어떤 토큰을 주목하는지” 눈으로 확인하기
- “학습 전엔 identity matrix처럼 보이지 않을까?”라는 오해를 직접 실험으로 검증해보기
- PyTorch
nn.Module로 재구현하기 - Multi-Head Attention을 직접 head 단위로 쪼개서 구현해보기 (+ 내장 구현과 비교)
- Causal Mask(디코더용)까지 확장하기
- (Part 2) Positional Encoding, Position-wise FFN, Residual/LayerNorm까지 채워서 논문 속 진짜 Transformer Encoder/Decoder를 완전히 조립하기
- (Part 2) 논문의 학습 레시피(Warmup, Dropout, Label Smoothing)와 실험 결과, 실제 학습된 모델의 attention 시각화까지 훑어보기
이 노트는 Vaswani et al., “Attention Is All You Need” (2017) 논문 전체를 기준으로 구성되어 있습니다. Part 1(1~10번)은 핵심 메커니즘(3.2절)을, Part 2(11번~)는 나머지 부분(구조·학습·결과)을 다룹니다.
참고로 이전에 RAG에서 썼던
vectorstore.similarity_search()도 사실 “쿼리 벡터와 각 청크 벡터의 유사도를 계산해서 가중치를 매기는” 것이었습니다. Self-Attention도 원리는 똑같습니다. Q(질문)와 K(검색 대상)의 유사도로 V(내용)에 가중치를 매기는 것 — RAG의 검색 개념이 Transformer 내부에도 그대로 들어있다고 생각하면 이해가 쉽습니다.
Setup
실습에 필요한 라이브러리는 torch, numpy, matplotlib 세 가지뿐입니다.
import numpy as np
import matplotlib.pyplot as plt

# 그래프에 한글 라벨(토큰 이름)을 쓸 것이므로 한글 폰트를 지정해둔다
# Windows 기본 한글 폰트인 맑은 고딕 사용, 없는 환경이면 이 줄만 원하는 폰트로 바꾸면 됨
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False  # 마이너스 기호가 네모로 깨지는 것 방지

np.random.seed(42)  # 이 노트북 전체에서 재현 가능하도록 시드 고정
이후 PyTorch가 필요한 시점(섹션 6)부터는 import torch, import torch.nn as nn을 추가로 불러옵니다.
Part 1. Self-Attention 핵심 메커니즘
논문 3.2절(Attention)을 중심으로, Self-Attention이 왜 필요한지부터 시작해서 직접 계산 → 시각화 → PyTorch 구현 → Multi-Head → Causal Mask → 실제 학습까지 이어갑니다.
1. Attention이 왜 등장했나 (Encoder-Decoder Attention 배경)
Self-Attention을 바로 보기 전에, Attention이라는 개념 자체가 왜 필요했는지 짚고 갑니다.
기존 RNN 기반 seq2seq의 한계
번역기 같은 걸 만들 때 옛날에는 Encoder-Decoder 구조를 썼습니다.
- Encoder: 입력 문장을 순서대로 읽어서 문장 전체 의미를 고정 크기의 벡터 하나(context vector)로 압축
- Decoder: 그 압축된 벡터 하나만 보고 출력 문장을 생성
문제는 문장이 길어질수록 그 많은 정보를 벡터 하나에 다 우겨넣다 보니 정보가 손실된다는 것이었습니다. 문장 앞부분 내용이 뒤로 갈수록 흐려지는 셈이죠.
Attention의 해결책
Decoder가 매 단어를 생성할 때마다, 압축된 벡터 하나만 보지 말고 Encoder가 만들어낸 모든 시점의 hidden state를 다시 참고하게 하자는 아이디어입니다. 그리고 그중 어디에 더 집중할지는 그때그때 다르게 정합니다. 계산은 크게 3단계입니다.
- Attention Score: 지금 Decoder가 보고 있는 상태와, Encoder의 각 시점 상태를 하나씩 내적(dot product)해서 “얼마나 관련있는지” 점수를 매김
- Attention Value: 그 점수들을 softmax로 확률분포(합이 1)로 바꾼 뒤, Encoder의 각 상태에 가중치로 곱해서 다 더함 — 즉 관련도가 높은 부분이 더 많이 반영된 요약 벡터가 나옴
- 이 요약 벡터를 Decoder의 현재 상태와 합쳐서 최종 출력을 만듦
이 “내적으로 관련도 점수를 매기고 → softmax로 가중치화하고 → 가중합한다”는 3단계 패턴이 그대로 Self-Attention의 뼈대가 됩니다. 차이는 RNN 없이, Query/Key/Value라는 이름으로 이 과정을 일반화했다는 점입니다.
2. Self-Attention이란 (Query, Key, Value)
\[\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]방금 본 Attention과 똑같은 3단계(점수 계산 → softmax → 가중합)를 하되, 문장 하나가 자기 자신에게 적용하는 것이 Self-Attention입니다. Encoder/Decoder를 나누지 않고, 한 문장 안의 토큰들끼리 서로 얼마나 관련있는지를 계산합니다.
Q, K, V를 도서관에 비유하면
- Query (Q): 내가 지금 찾고 싶은 주제 — “이거랑 관련된 걸 찾아줘”
- Key (K): 책마다 붙어있는 분류 태그 — 검색당하는 쪽이 자기를 표현하는 특징
- Value (V): 그 책의 실제 내용물 — Query와 Key가 얼마나 잘 맞는지로 “얼마나 가져올지”를 정하고, 실제로 가져오는 건 Value
같은 토큰 임베딩 \(X\)에서 출발하지만, 서로 다른 학습 가중치 \(W_q, W_k, W_v\)를 곱해서 Q/K/V를 각각 다르게 만듭니다. 그래서 같은 토큰이라도 “질문 역할일 때”와 “검색당하는 역할일 때”의 표현이 달라집니다.
- \(\sqrt{d_k}\)로 나누는 이유: 차원이 커질수록 \(QK^T\) 값이 커져서 softmax가 한쪽으로 쏠리는(gradient가 죽는) 걸 막기 위한 스케일링
예시로 먼저 감을 잡아보자
"I am a student"라는 문장으로 감을 잡아봅니다. 아직 학습되지 않은 랜덤 벡터로는 의미있는 패턴이 안 나오니, “I”와 “student”가 둘 다 사람을 가리킨다는 걸 임베딩에 일부러 반영해서, Self-Attention이 실제로 관련 있는 단어끼리 더 주목하게 되는지 확인해봅니다.
def softmax(x, axis=-1):
    # 오버플로우 방지를 위해 최댓값을 빼고 지수화 (앞으로 계속 재사용)
    e_x = np.exp(x - np.max(x, axis=axis, keepdims=True))
    return e_x / np.sum(e_x, axis=axis, keepdims=True)

words = ["I", "am", "a", "student"]

# 첫 번째 성분을 "사람을 가리키는 정도"라고 생각하고 값을 직접 넣어봤다
# I와 student가 겹치는 성분(0.8)을 갖도록 만들어서, 실제로 서로 더 주목하는지 확인해본다
embeddings = np.array([
    [1.0, 0.0, 0.0, 0.0],   # I
    [0.0, 1.0, 0.0, 0.0],   # am
    [0.0, 0.0, 1.0, 0.0],   # a
    [0.8, 0.0, 0.0, 1.0],   # student
])

# 가중치 행렬(Wq/Wk) 없이(=단위행렬로 대체) 순수 유사도만 확인 -> Q=K=V=embeddings
d_k = embeddings.shape[1]
scores = embeddings @ embeddings.T / np.sqrt(d_k)
weights = softmax(scores, axis=-1)

print("단어별 attention weight (자기 자신 제외하고 가장 높은 값에 주목):")
for i, w in enumerate(words):
    row = ", ".join(f"{words[j]}={weights[i, j]:.2f}" for j in range(len(words)))
    print(f"{w:>8} ->{row}")
실행 결과
단어별 attention weight (자기 자신 제외하고 가장 높은 값에 주목):
       I -> I=0.32, am=0.19, a=0.19, student=0.29
      am -> I=0.22, am=0.35, a=0.22, student=0.22
       a -> I=0.22, am=0.22, a=0.35, student=0.22
 student -> I=0.26, am=0.17, a=0.17, student=0.39
I 행을 보면 student(0.29)에 대한 weight가 am(0.19), a(0.19)보다 뚜렷하게 높습니다 — 임베딩에 일부러 심어둔 “사람을 가리키는 성분”이 attention weight에 그대로 반영된 것입니다. 이게 바로 실제 학습된 모델이 하고자 하는 일이고, 우리는 지금 그 결과만 손으로 흉내낸 것입니다.
3. NumPy로 일반화해서 구현해보기
방금은 임베딩을 손으로 짜맞춘 특수한 예시였습니다. 이번엔 실제로 학습되는 가중치 \(W_q, W_k, W_v\)를 랜덤하게 두고, 토큰 임베딩도 랜덤으로 둔 채로 Self-Attention 전체 과정을 계산해봅니다.
seq_len = 4   # 토큰 개수 (문장 길이)
d_model = 8   # 임베딩 차원

# 토큰 4개짜리 문장의 임베딩이라고 가정하고 랜덤 생성
X = np.random.randn(seq_len, d_model)
print("입력 X (토큰 임베딩), shape:", X.shape)
print(X)
실행 결과
입력 X (토큰 임베딩), shape: (4, 8)
[[ 0.49671415 -0.1382643   0.64768854  1.52302986 -0.23415337 -0.23413696
   1.57921282  0.76743473]
 [-0.46947439  0.54256004 -0.46341769 -0.46572975  0.24196227 -1.91328024
  -1.72491783 -0.56228753]
 [-1.01283112  0.31424733 -0.90802408 -1.4123037   1.46564877 -0.2257763
   0.0675282  -1.42474819]
 [-0.54438272  0.11092259 -1.15099358  0.37569802 -0.60063869 -0.29169375
  -0.60170661  1.85227818]]
이제 이 임베딩을 Q, K, V로 변환합니다. 각 변환은 학습 가능한 파라미터 행렬 \(W_q, W_k, W_v\)와의 행렬곱입니다.
# Q, K, V로 변환하는 가중치 행렬 (실제 학습되는 파라미터에 해당)
d_k = d_model  # 이 예제에서는 Q/K/V 차원을 입력과 동일하게 둔다
Wq = np.random.randn(d_model, d_k)
Wk = np.random.randn(d_model, d_k)
Wv = np.random.randn(d_model, d_k)

Q = X @ Wq
K = X @ Wk
V = X @ Wv

print("Q shape:", Q.shape)
print("K shape:", K.shape)
print("V shape:", V.shape)
실행 결과
Q shape: (4, 8)
K shape: (4, 8)
V shape: (4, 8)
다음은 논문 수식의 핵심인 \(QK^T / \sqrt{d_k}\)와 softmax입니다.
# 토큰끼리의 유사도 점수 (QK^T), sqrt(d_k)로 스케일링
scores = (Q @ K.T) / np.sqrt(d_k)
print("scores (스케일링 전 유사도), shape:", scores.shape)
print(scores)

# softmax로 각 토큰이 다른 토큰에 주목하는 비율(가중치)로 변환 (softmax는 위에서 정의해둔 걸 재사용)
attn_weights = softmax(scores, axis=-1)
print("\nattention weights (각 행의 합은 1):")
print(attn_weights)
print("행별 합 검증:", attn_weights.sum(axis=-1))
실행 결과
scores (스케일링 전 유사도), shape: (4, 4)
[[-6.22595052  5.51974196 -1.51290328  2.0776227 ]
 [ 3.9156704  -5.01495199 -1.26501828  7.21668366]
 [ 6.2732906  -3.57846232  0.75964575 -6.82973652]
 [-3.53973959  3.0546337  -1.0450873   0.03707887]]

attention weights (각 행의 합은 1):
[[7.67109958e-06 9.68159817e-01 8.54492061e-04 3.09780198e-02]
 [3.55291769e-02 4.69964577e-06 1.99820777e-04 9.64266303e-01]
 [9.95930547e-01 5.24405365e-05 4.01498126e-03 2.03075101e-06]
 [1.28230159e-03 9.37324806e-01 1.55383143e-02 4.58545778e-02]]
행별 합 검증: [1. 1. 1. 1.]
마지막으로 이 가중치로 V를 가중합하면 Self-Attention의 최종 출력입니다.
# 가중치로 V를 가중합 -> 최종 Self-Attention 출력
output = attn_weights @ V
print("Self-Attention 출력, shape:", output.shape)
print(output)
실행 결과
Self-Attention 출력, shape: (4, 8)
[[-0.68939668 -9.494128   -3.80341092 -5.16705409 -0.79426991  2.65945449
  -0.2745543  -2.76803143]
 [-1.53799964 -3.63883052 -1.78878269 -3.6322275   3.08543646 -3.41871396
   1.81548257 -3.84564413]
 [-0.68259115  8.532587    1.47193389  2.85720415  3.38479494 -2.89007239
  -1.1052181   2.53127537]
 [-0.65523578 -9.31506043 -3.72747038 -5.08239805 -0.78336268  2.60103655
  -0.23924841 -2.78183549]]
입력 X와 출력의 shape이 (4, 8)로 동일하다는 점에 주목하세요 — Self-Attention은 “토큰 개수 × 차원” 모양을 그대로 유지한 채, 각 토큰의 내용만 문맥을 반영해서 바꿔주는 연산입니다.
4. Attention Weight 시각화
숫자만으로는 어떤 토큰이 어떤 토큰을 주목하는지 감이 잘 안 옵니다. 히트맵으로 그려서 눈으로 확인합니다.
tokens = [f"토큰{i}" for i in range(seq_len)]

fig, ax = plt.subplots(figsize=(5, 4))
im = ax.imshow(attn_weights, cmap="viridis")

ax.set_xticks(range(seq_len))
ax.set_yticks(range(seq_len))
ax.set_xticklabels(tokens)
ax.set_yticklabels(tokens)
ax.set_xlabel("Key (주목 대상)")
ax.set_ylabel("Query (주목하는 주체)")
ax.set_title("Self-Attention Weights")

# 칸마다 숫자 표시
for i in range(seq_len):
    for j in range(seq_len):
        ax.text(j, i, f"{attn_weights[i, j]:.2f}", ha="center", va="center", color="white")

fig.colorbar(im)
plt.tight_layout()
plt.show()
Self-Attention Weights 히트맵
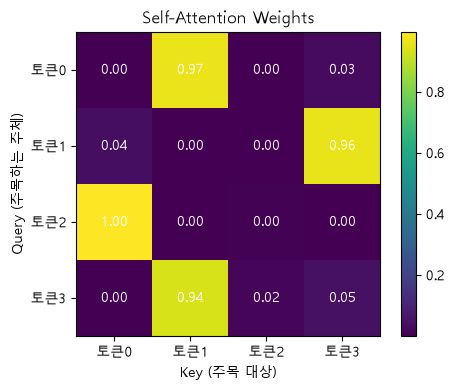
Self-Attention Weights 히트맵
행(Query)마다 색이 밝은 칸(값이 큰 칸)이 하나씩 두드러지는 걸 볼 수 있습니다 — 이 예시는 Wq, Wk가 완전히 독립적인 랜덤 행렬이라, 어느 토큰이 어느 토큰에 쏠릴지는 사실상 “우연”입니다. 다음 섹션에서 이 점을 더 파봅니다.
5. 왜 대각선이 항상 크지는 않은가 (Q=K인 경우와 비교)
바로 위 히트맵(4번)에서는 Wq와 Wk가 서로 독립적인 랜덤 행렬이라 대각선(자기 자신)이 특별히 크지 않았습니다. “학습 전엔 identity matrix처럼 보이지 않을까?”라는 오해가 나올 만한데, 실제로는 학습 여부가 아니라 Q와 K가 서로 얼마나 같은 표현을 공유하는지가 관건입니다. Q = K = X로 두면 어떻게 달라지는지 직접 비교해봅니다.
Q = K = X일 때:scores[i, j] = X_i · X_j가 됩니다. 코시-슈바르츠 부등식에 따라X_i · X_j <= ||X_i|| * ||X_j||이고,X_i · X_i = ||X_i||²이므로, 벡터들의 크기(norm)가 서로 비슷하다면 자기 자신과의 내적이 그 행에서 가장 커지는 경향이 생깁니다. 그래서 softmax를 거치면 대각선이 두드러집니다.Wq ≠ Wk(독립적인 랜덤 가중치)일 때:Q_i와K_i가 서로 무관한 벡터가 되면서 이 성질이 깨지고, 대각선이 특별할 이유가 사라집니다.
즉 두 경우 다 “학습 안 된 상태”지만, Q와 K를 어떻게 만드느냐에 따라 완전히 다른 패턴이 나옵니다.
# 비교 1: Q = K = X (별도 가중치 없이 그대로 사용) -> 대각선이 지배적인 경향
scores_qk_equal = (X @ X.T) / np.sqrt(d_model)
weights_qk_equal = softmax(scores_qk_equal, axis=-1)

# 비교 2: 기존처럼 Wq, Wk가 독립적인 랜덤 행렬인 경우 (attn_weights, 4번 섹션에서 이미 계산해둔 값 재사용)

fig, axes = plt.subplots(1, 2, figsize=(11, 4))

for ax, weights, title in zip(
    axes,
    [weights_qk_equal, attn_weights],
    ["Q = K = X\n(대각선이 지배적)", "Q, K가 독립적인 랜덤 행렬\n(랜덤한 패턴)"],
):
    im = ax.imshow(weights, cmap="viridis", vmin=0, vmax=1)
    ax.set_xticks(range(seq_len))
    ax.set_yticks(range(seq_len))
    ax.set_xticklabels(tokens)
    ax.set_yticklabels(tokens)
    ax.set_title(title)
    for i in range(seq_len):
        for j in range(seq_len):
            ax.text(j, i, f"{weights[i, j]:.2f}", ha="center", va="center", color="white", fontsize=8)

fig.colorbar(im, ax=axes, fraction=0.046, pad=0.04)
plt.show()

print("Q=K=X일 때 대각선 값:        ", np.diag(weights_qk_equal).round(3))
print("Q,K가 독립적인 랜덤일 때 대각선 값:", np.diag(attn_weights).round(3))
Q=K=X vs 독립적인 랜덤 Q,K 비교
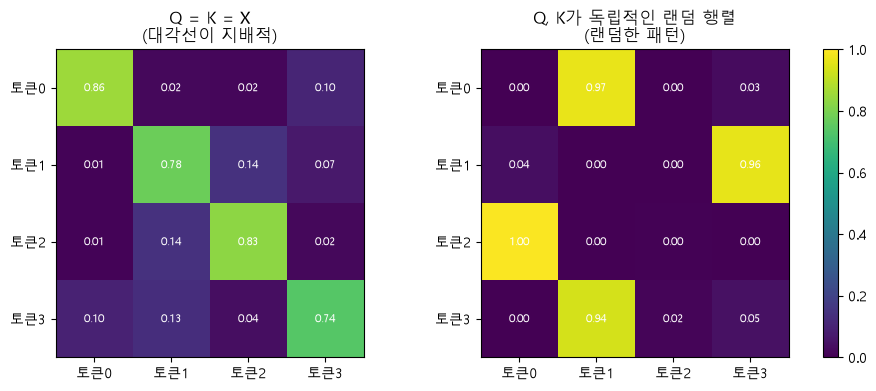
Q=K=X vs 독립적인 랜덤 Q,K 비교
실행 결과
Q=K=X일 때 대각선 값:         [0.855 0.776 0.829 0.738]
Q,K가 독립적인 랜덤일 때 대각선 값: [0.    0.    0.004 0.046]
표준 Transformer의 Wq, Wk는 (identity가 아니라) 독립적인 랜덤 행렬로 초기화되므로, 학습 시작 시점의 실제 attention은 identity matrix가 아니라 오른쪽 그래프처럼 랜덤한 패턴에 가깝습니다. 학습이 진행되면서 태스크에 유리한 방향으로 Wq, Wk가 조정되고, 그 결과로 (필요하다면) 특정 head가 대각선 근처에 수렴하거나 전혀 다른 의미있는 패턴으로 수렴합니다 — 즉 구조는 초기 상태가 아니라 학습의 결과물입니다.
6. PyTorch로 재구현 (nn.Module)
NumPy로 원리를 확인했으니, 실전에서 쓰는 방식대로 nn.Module로 캡슐화합니다. 학습 가능한 파라미터(nn.Linear)로 Q/K/V를 만드는 것 외에는 위와 완전히 동일한 계산입니다.
import torch
import torch.nn as nn

class SelfAttention(nn.Module):
    def __init__(self, d_model, d_k):
        super().__init__()
        self.d_k = d_k
        # bias=False: 원래 Transformer 논문의 attention projection도 bias를 안 씀
        self.Wq = nn.Linear(d_model, d_k, bias=False)
        self.Wk = nn.Linear(d_model, d_k, bias=False)
        self.Wv = nn.Linear(d_model, d_k, bias=False)

    def forward(self, x, mask=None):
        # x: (batch, seq_len, d_model)
        Q = self.Wq(x)
        K = self.Wk(x)
        V = self.Wv(x)

        scores = Q @ K.transpose(-2, -1) / (self.d_k ** 0.5)

        if mask is not None:
            # mask==0인 위치는 -inf로 채워서 softmax 후 가중치가 0이 되게 함
            scores = scores.masked_fill(mask == 0, float("-inf"))

        attn_weights = torch.softmax(scores, dim=-1)
        output = attn_weights @ V
        return output, attn_weights

torch.manual_seed(42)
x = torch.randn(1, seq_len, d_model)  # batch=1

attn = SelfAttention(d_model=d_model, d_k=d_model)
out, weights = attn(x)

print("출력 shape:", out.shape)          # (1, seq_len, d_k)
print("가중치 shape:", weights.shape)     # (1, seq_len, seq_len)
실행 결과
출력 shape: torch.Size([1, 4, 8])
가중치 shape: torch.Size([1, 4, 4])
이제부터 batch 차원이 shape 맨 앞에 하나 추가된 것 외에는 NumPy 버전과 완전히 같은 계산입니다. 이 SelfAttention 클래스는 이후 섹션에서 계속 재사용합니다.
7. Multi-Head Attention
혼자서 한 번만 Attention을 계산하는 대신, 여러 명의 검토자에게 각자 다른 관점으로 동시에 보게 한 다음 의견을 모으는 것이 Multi-Head Attention입니다. head마다 서로 다른 문법적/의미적 관계에 주목할 여지를 주는 것이 목적입니다.
실제로 head를 나누는 방식
- Q, K, V(각각
d_model차원)를 head 개수만큼 쪼갭니다. head가 4개면 각 head는d_model / 4차원만 담당 - 쪼개진 head마다 독립적으로 Scaled Dot-Product Attention을 계산
- head별 결과를 다시 이어붙인(concat) 뒤, 마지막에 한 번 더 선형변환(
Wo)해서 최종 출력을 만듦
전체 차원(d_model)은 그대로 유지되면서, 여러 관점을 동시에 반영할 수 있게 되는 구조입니다.
논문 Figure 2가 이 두 가지(왼쪽: 우리가 이미 구현한 Scaled Dot-Product Attention, 오른쪽: 지금 만들 Multi-Head Attention)를 정확히 그림으로 보여줍니다.
Scaled Dot-Product Attention과 Multi-Head Attention
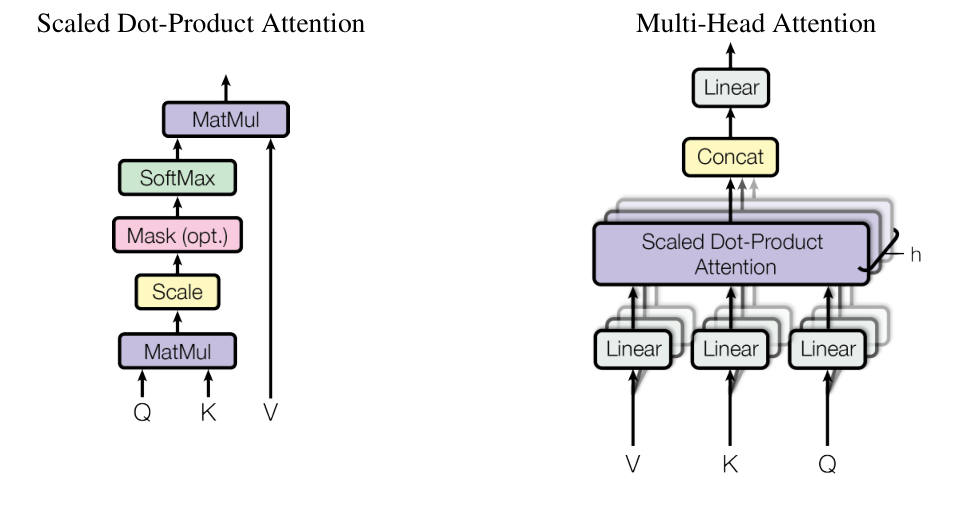
출처: Vaswani et al., “Attention Is All You Need” (2017), Figure 2. 논문 permission에 따라 학습 목적으로 재수록.
먼저 이 쪼개기 → 계산 → concat 과정을 직접 구현해서 내부 동작을 눈으로 확인해봅니다.
class ManualMultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        assert d_model % num_heads == 0, "d_model은 num_heads로 나누어떨어져야 head를 균등하게 쪼갤 수 있음"
        self.num_heads = num_heads
        self.d_head = d_model // num_heads

        self.Wq = nn.Linear(d_model, d_model, bias=False)
        self.Wk = nn.Linear(d_model, d_model, bias=False)
        self.Wv = nn.Linear(d_model, d_model, bias=False)
        self.Wo = nn.Linear(d_model, d_model, bias=False)  # concat 후 최종 projection

    def split_heads(self, x):
        # (batch, seq_len, d_model) -> (batch, num_heads, seq_len, d_head)
        batch, seq_len, d_model = x.shape
        x = x.view(batch, seq_len, self.num_heads, self.d_head)
        return x.transpose(1, 2)

    def forward(self, x):
        batch, seq_len, d_model = x.shape

        Q = self.split_heads(self.Wq(x))
        K = self.split_heads(self.Wk(x))
        V = self.split_heads(self.Wv(x))

        # head마다 독립적으로 Scaled Dot-Product Attention
        scores = Q @ K.transpose(-2, -1) / (self.d_head ** 0.5)
        weights = torch.softmax(scores, dim=-1)
        head_outputs = weights @ V  # (batch, num_heads, seq_len, d_head)

        # head들을 다시 이어붙임(concat) -> (batch, seq_len, d_model)
        concat = head_outputs.transpose(1, 2).contiguous().view(batch, seq_len, d_model)
        output = self.Wo(concat)
        return output, weights

torch.manual_seed(42)
num_heads = 2  # d_model=8을 2개 head로 나누면 head당 차원은 4

manual_mha = ManualMultiHeadAttention(d_model=d_model, num_heads=num_heads)
manual_out, manual_weights = manual_mha(x)

print("최종 출력 shape:", manual_out.shape)        # (1, seq_len, d_model) - head로 쪼개기 전과 동일
print("head별 가중치 shape:", manual_weights.shape)  # (1, num_heads, seq_len, seq_len) - head마다 따로 있음
print("\nhead 0의 attention weights:")
print(manual_weights[0, 0].detach().numpy().round(2))
print("\nhead 1의 attention weights (head마다 다른 패턴에 주목함을 확인):")
print(manual_weights[0, 1].detach().numpy().round(2))
실행 결과
최종 출력 shape: torch.Size([1, 4, 8])
head별 가중치 shape: torch.Size([1, 2, 4, 4])

head 0의 attention weights:
[[0.2  0.26 0.31 0.22]
 [0.37 0.25 0.09 0.28]
 [0.32 0.16 0.35 0.17]
 [0.32 0.16 0.35 0.17]]

head 1의 attention weights (head마다 다른 패턴에 주목함을 확인):
[[0.33 0.31 0.16 0.21]
 [0.19 0.24 0.18 0.4 ]
 [0.43 0.2  0.23 0.14]
 [0.26 0.24 0.31 0.2 ]]
head 0과 head 1의 가중치 행렬이 서로 다르다는 점이 핵심입니다 — 같은 입력을 봐도 head마다 다른 관점(다른 가중치 Wq, Wk)으로 주목하고 있습니다.
내장 구현과 비교
실무에서는 위 과정을 직접 구현하지 않고 PyTorch가 제공하는 nn.MultiheadAttention을 씁니다. 내부적으로 방금 만든 것과 똑같은 일(쪼개기 → head별 계산 → concat → projection)을 하므로, 출력 shape이 동일한지만 확인해봅니다 (가중치 초기화가 서로 다르므로 값 자체는 다릅니다).
mha = nn.MultiheadAttention(embed_dim=d_model, num_heads=num_heads, batch_first=True)

# Self-Attention이므로 query, key, value에 전부 같은 입력을 넣는다
mha_out, mha_weights = mha(x, x, x)

print("Multi-Head 출력 shape:", mha_out.shape)                 # (1, seq_len, d_model) - 직접 구현한 것과 동일
print("Multi-Head 평균 가중치 shape:", mha_weights.shape)       # (1, seq_len, seq_len), 기본값은 head 평균
실행 결과
Multi-Head 출력 shape: torch.Size([1, 4, 8])
Multi-Head 평균 가중치 shape: torch.Size([1, 4, 4])
nn.MultiheadAttention은 기본적으로 head별 가중치를 평균 내서 (batch, seq_len, seq_len) 하나로 돌려줍니다 — head 각각을 보고 싶다면 average_attn_weights=False 옵션을 주면 됩니다.
8. Causal Mask (디코더용 마스킹)
GPT 같은 디코더 모델은 “미래 토큰을 미리 보면 안 되는” 제약이 있습니다. 그래서 각 토큰이 자기 자신과 그 이전 토큰까지만 볼 수 있도록 마스킹합니다. 마스크를 씌우기 전/후 가중치를 비교해봅니다.
# 하삼각(lower-triangular) 마스크: 1이면 볼 수 있음, 0이면 못 봄
causal_mask = torch.tril(torch.ones(seq_len, seq_len)).bool()
print("causal mask:")
print(causal_mask.int())

out_masked, weights_masked = attn(x, mask=causal_mask)

print("\n마스킹 전 가중치 (앞서 계산해둔 weights 재사용):")
print(weights.squeeze(0).detach().numpy().round(2))
print("\n마스킹 후 가중치 (오른쪽 위 삼각형이 전부 0이 됨 = 미래 토큰을 못 봄):")
print(weights_masked.squeeze(0).detach().numpy().round(2))
실행 결과
causal mask:
tensor([[1, 0, 0, 0],
        [1, 1, 0, 0],
        [1, 1, 1, 0],
        [1, 1, 1, 1]], dtype=torch.int32)

마스킹 전 가중치 (앞서 계산해둔 weights 재사용):
[[0.33 0.22 0.19 0.26]
 [0.2  0.26 0.23 0.32]
 [0.36 0.25 0.26 0.13]
 [0.17 0.27 0.37 0.19]]

마스킹 후 가중치 (오른쪽 위 삼각형이 전부 0이 됨 = 미래 토큰을 못 봄):
[[1.   0.   0.   0.  ]
 [0.43 0.57 0.   0.  ]
 [0.41 0.29 0.3  0.  ]
 [0.17 0.27 0.37 0.19]]
첫 번째 토큰은 자기 자신밖에 볼 수 없어서 weight가 [1, 0, 0, 0]으로 강제되고, 마지막 토큰은 모든 위치를 다 볼 수 있어서 마스킹 전과 값이 동일합니다. masked_fill로 -inf를 채운 뒤 softmax를 거치면 그 위치의 확률이 정확히 0이 된다는 점이 핵심 트릭입니다.
9. 실전 예제: 문장에 Self-Attention 적용해보기
랜덤 벡터 대신, 실제 문장을 토큰화하고 nn.Embedding으로 임베딩한 뒤 어떤 단어가 어떤 단어에 주목하는지 시각화합니다. (사전학습 임베딩이 아니라 랜덤 초기화이므로 의미상 그럴듯한 패턴이 나오진 않습니다 — 학습을 거쳐야 의미 있는 attention이 만들어진다는 걸 확인하는 게 이 셀의 포인트입니다. 앞서 “I am a student” 예제는 반대로 임베딩을 손으로 짜맞춰서 학습 후 상태를 흉내낸 것이었습니다.)
sentence = ["나는", "오늘", "랭체인을", "공부한다"]
vocab = {w: i for i, w in enumerate(sentence)}

torch.manual_seed(0)
embedding = nn.Embedding(num_embeddings=len(vocab), embedding_dim=d_model)

token_ids = torch.tensor([[vocab[w] for w in sentence]])  # (1, seq_len)
sent_x = embedding(token_ids)  # (1, seq_len, d_model)

_, sent_weights = attn(sent_x)
sent_weights = sent_weights.squeeze(0).detach().numpy()

fig, ax = plt.subplots(figsize=(5, 4))
im = ax.imshow(sent_weights, cmap="viridis")
ax.set_xticks(range(len(sentence)))
ax.set_yticks(range(len(sentence)))
ax.set_xticklabels(sentence)
ax.set_yticklabels(sentence)
ax.set_title("문장에 대한 Self-Attention (학습 전, 랜덤 가중치)")
for i in range(len(sentence)):
    for j in range(len(sentence)):
        ax.text(j, i, f"{sent_weights[i, j]:.2f}", ha="center", va="center", color="white")
fig.colorbar(im)
plt.tight_layout()
plt.show()
문장에 대한 Self-Attention (학습 전)
학습 전이라 “나는”과 “공부한다”가 의미적으로 연결되어야 한다는 패턴은 보이지 않습니다. 다음 섹션에서 이 문장을 실제로 학습시켜서, attention이 어떻게 바뀌는지 확인합니다.
10. Self-Attention 실제로 학습시켜보기
지금까지는 전부 학습되지 않은(랜덤 초기화) 가중치로 실험했습니다. 이번엔 실제로 파라미터를 업데이트시켜서, 학습 전/후 attention 패턴이 어떻게 달라지는지 확인해봅니다.
어떤 과제로 학습시킬까
Self-Attention 혼자서는 학습시킬 “정답”이 없습니다 — 정답이 있어야 loss를 계산하고 gradient를 흘릴 수 있습니다. 그래서 가장 간단한 과제인 “다음 단어 맞히기”(언어모델링)를 붙입니다.
- 입력:
나는 오늘 랭체인을(앞부분) - 정답: 각 위치 다음에 오는 단어 (
오늘,랭체인을,공부한다) - 미래 단어를 보면 안 되므로 8번에서 만든 Causal Mask를 그대로 사용
문장이 딱 하나뿐이라 실제 의미를 학습한다기보다는 이 한 문장을 통째로 외우는(overfit) 것에 가깝지만, “학습 전 랜덤한 attention”이 “학습 후 특정 패턴으로 수렴한 attention”으로 바뀌는 과정 자체는 충분히 관찰할 수 있습니다. 문장이 여러 개인 진짜 말뭉치로 학습시키면 훨씬 일반적인 패턴을 배우게 됩니다.
import torch.optim as optim

sentence9 = ["나는", "오늘", "랭체인을", "공부한다"]
vocab9 = {w: i for i, w in enumerate(sentence9)}
vocab_size9 = len(vocab9)

torch.manual_seed(0)
embedding9 = nn.Embedding(vocab_size9, d_model)
attn9 = SelfAttention(d_model=d_model, d_k=d_model)
output_head9 = nn.Linear(d_model, vocab_size9)  # attention 출력을 단어별 점수(logit)로 변환

token_ids9 = torch.tensor([[vocab9[w] for w in sentence9]])  # (1, seq_len)
causal_mask9 = torch.tril(torch.ones(len(sentence9), len(sentence9))).bool()
targets9 = token_ids9[:, 1:]  # 각 위치의 "다음 단어" 정답, 마지막 토큰은 다음이 없으므로 제외

# 비교를 위해 학습 전 attention weight를 미리 찍어둔다
with torch.no_grad():
    x9 = embedding9(token_ids9)
    _, weights_before = attn9(x9, mask=causal_mask9)

optimizer = optim.Adam(
    list(embedding9.parameters()) + list(attn9.parameters()) + list(output_head9.parameters()),
    lr=0.05,
)
loss_fn = nn.CrossEntropyLoss()

num_epochs = 300
loss_history = []  # Part 2(18번)에서 학습 레시피를 비교할 때 재사용
for epoch in range(num_epochs):
    x9 = embedding9(token_ids9)
    out9, weights_after = attn9(x9, mask=causal_mask9)
    logits = output_head9(out9)  # (1, seq_len, vocab_size)

    # 마지막 위치는 정답(다음 단어)이 없으므로 제외하고 손실 계산
    loss = loss_fn(logits[:, :-1].reshape(-1, vocab_size9), targets9.reshape(-1))

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    loss_history.append(loss.item())

    if epoch % 50 == 0:
        print(f"epoch{epoch:3d}: loss={loss.item():.4f}")

print("최종 loss:", loss.item())
실행 결과
epoch   0: loss=1.4371
epoch  50: loss=0.0000
epoch 100: loss=0.0000
epoch 150: loss=0.0000
epoch 200: loss=0.0000
epoch 250: loss=0.0000
최종 loss: 0.0
문장이 하나뿐이라 300 epoch 안에 loss가 사실상 0까지 떨어집니다(완전히 외운 상태). 학습 전/후 attention weight를 나란히 비교해봅니다.
# 학습 전/후 attention weight 비교
w_before = weights_before.squeeze(0).detach().numpy()
w_after = weights_after.squeeze(0).detach().numpy()

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
for ax, w, title in zip(
    axes,
    [w_before, w_after],
    ["학습 전 (랜덤 초기화)", f"학습 후 ({num_epochs}epoch, loss={loss.item():.3f})"],
):
    im = ax.imshow(w, cmap="viridis", vmin=0, vmax=1)
    ax.set_xticks(range(len(sentence9)))
    ax.set_yticks(range(len(sentence9)))
    ax.set_xticklabels(sentence9)
    ax.set_yticklabels(sentence9)
    ax.set_title(title)
    for i in range(len(sentence9)):
        for j in range(len(sentence9)):
            ax.text(j, i, f"{w[i, j]:.2f}", ha="center", va="center", color="white", fontsize=8)
fig.colorbar(im, ax=axes, fraction=0.046, pad=0.04)
plt.show()
학습 전후 attention weight 비교
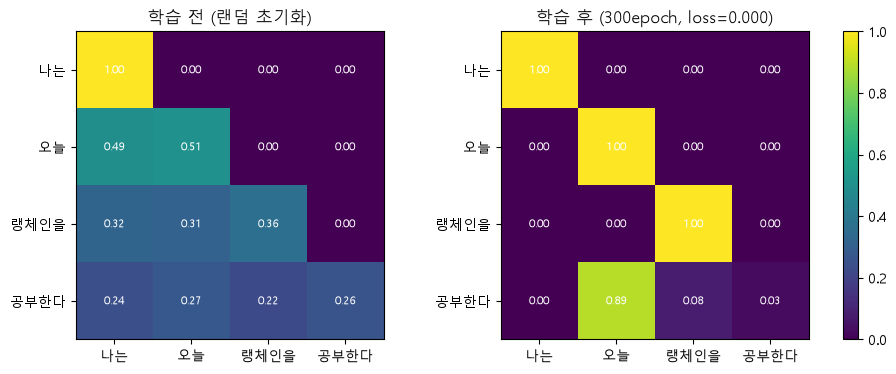
학습 후에는 특정 칸에 가중치가 뚜렷하게 몰려있는 걸 볼 수 있습니다 — 다음 단어를 맞히는 데 유리한 위치로 attention이 정확히 수렴한 것입니다. 마지막으로, 실제로 이 문장을 정확히 “외웠는지” 다음 단어 예측으로 확인합니다.
# 실제로 문장을 외웠는지, 다음 단어 예측으로 확인해보자
with torch.no_grad():
    x9 = embedding9(token_ids9)
    out9, _ = attn9(x9, mask=causal_mask9)
    logits = output_head9(out9)
    preds = logits.argmax(dim=-1).squeeze(0).tolist()

print("입력:          ", sentence9)
print("다음 단어 예측:  ", [sentence9[p] for p in preds])
print("(앞 3개 예측이 순서대로 '오늘', '랭체인을', '공부한다'와 같으면 문장을 정확히 외운 것)")
실행 결과
입력:           ['나는', '오늘', '랭체인을', '공부한다']
다음 단어 예측:   ['오늘', '랭체인을', '공부한다', '랭체인을']
(앞 3개 예측이 순서대로 '오늘', '랭체인을', '공부한다'와 같으면 문장을 정확히 외운 것)
앞 3개(오늘, 랭체인을, 공부한다)가 정답과 정확히 일치합니다 — Self-Attention + 다음 단어 예측만으로 이 문장을 완벽하게 학습했습니다. (마지막 위치는 정답 자체가 없어서 예측 결과가 의미 없습니다.)
Part 2. 논문의 나머지 부분 채우기
여기까지가 논문 3.2절(Attention 메커니즘) 중심의 Part 1이었습니다. 지금부터는 “Attention Is All You Need” 논문 전체를 기준으로, 아직 안 다룬 부분들을 하나씩 채워서 최종적으로 완전한 Transformer Encoder(+ Decoder 맛보기)를 조립합니다.
다룰 내용: Positional Encoding · Position-wise FFN · Residual/LayerNorm · Encoder/Decoder 조립 · Embedding Weight Tying · 계산 복잡도 비교 · 논문 학습 레시피(Warmup/Dropout/Label Smoothing) · 실험 결과 · 실제 학습된 모델의 Attention 시각화
11. Positional Encoding — 순서 정보 주입하기
왜 필요한가
지금까지 만든 Self-Attention을 잘 보면 이상한 점이 있습니다. scores = Q @ K.T는 토큰 벡터들 사이의 내적으로만 계산되는데, 이 계산에는 “몇 번째 토큰인지”에 대한 정보가 전혀 들어있지 않습니다. 문장 [나는, 오늘, 공부한다]와 [오늘, 공부한다, 나는]을 넣어도, 등장하는 토큰 집합만 같다면 Self-Attention은 (순서만 바뀐 채) 똑같이 계산합니다 — RNN처럼 “순서대로 하나씩 처리”하는 구조가 아니기 때문입니다.
그래서 논문은 임베딩에 위치 정보(Positional Encoding)를 더해서 순서를 알려줍니다.
논문의 수식
\[PE_{(pos,\ 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{model}}}\right) \qquad PE_{(pos,\ 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{model}}}\right)\]pos: 토큰의 위치 (0, 1, 2, …)i: 임베딩 차원의 인덱스- 짝수 번째 차원은 sin, 홀수 번째 차원은 cos를 사용 — 위치마다 서로 다른 파형 패턴을 만들어서 각 위치가 고유한 벡터를 갖게 함
- 학습되는 파라미터가 아니라 고정된 값이라는 게 특징입니다 (논문에서 학습되는 위치 임베딩과도 비교했는데, 성능 차이가 거의 없었다고 합니다)
Figure 1에서 “Positional Encoding”이 Input/Output Embedding에 더해지는(⊕) 부분이 바로 이것입니다.
Transformer 전체 구조
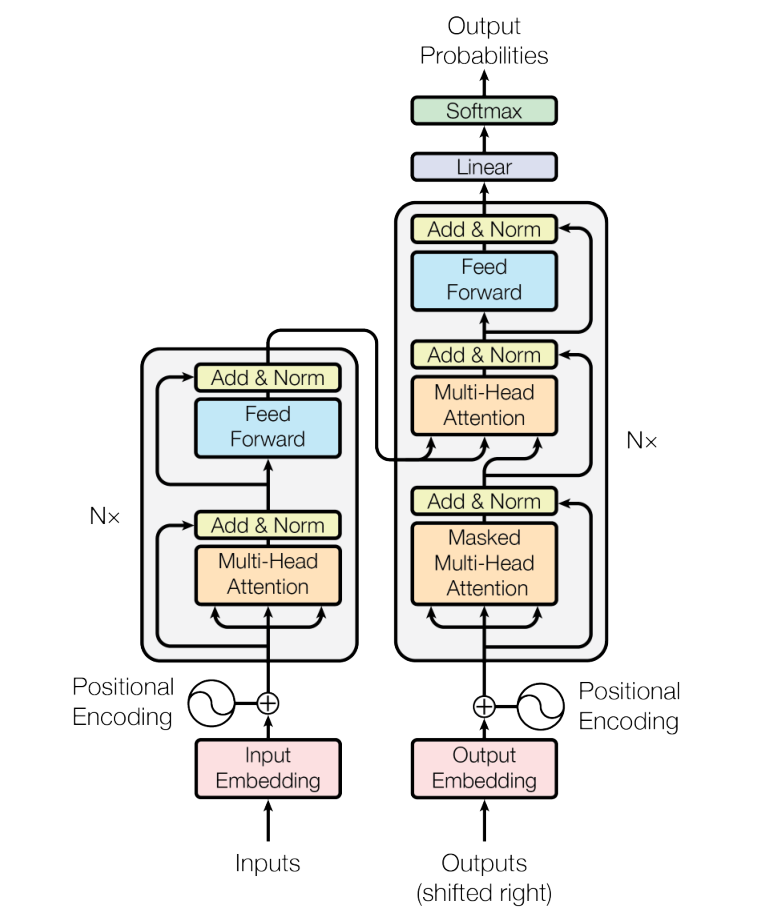
출처: Vaswani et al., “Attention Is All You Need” (2017), Figure 1. 논문 1페이지에 “Google hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works”라고 명시되어 있어, 학습 목적으로 재수록했습니다.
def positional_encoding(seq_len, d_model):
    # (seq_len, d_model) 크기의 위치 인코딩 행렬을 만든다
    position = np.arange(seq_len)[:, np.newaxis]         # (seq_len, 1)
    i = np.arange(d_model)[np.newaxis, :]                 # (1, d_model)
    angle_rates = 1 / np.power(10000, (2 * (i // 2)) / d_model)
    angle_rads = position * angle_rates

    pe = np.zeros((seq_len, d_model))
    pe[:, 0::2] = np.sin(angle_rads[:, 0::2])   # 짝수 인덱스 -> sin
    pe[:, 1::2] = np.cos(angle_rads[:, 1::2])   # 홀수 인덱스 -> cos
    return pe

pe = positional_encoding(seq_len=seq_len, d_model=d_model)
print("Positional Encoding shape:", pe.shape)
print(pe.round(3))
실행 결과
Positional Encoding shape: (4, 8)
[[ 0.     1.     0.     1.     0.     1.     0.     1.   ]
 [ 0.841  0.54   0.1    0.995  0.01   1.     0.001  1.   ]
 [ 0.909 -0.416  0.199  0.98   0.02   1.     0.002  1.   ]
 [ 0.141 -0.99   0.296  0.955  0.03   1.     0.003  1.   ]]
fig, ax = plt.subplots(figsize=(6, 4))
im = ax.imshow(pe, cmap="RdBu", aspect="auto")
ax.set_xlabel("임베딩 차원 (i)")
ax.set_ylabel("위치 (pos)")
ax.set_title("Positional Encoding 값")
fig.colorbar(im)
plt.tight_layout()
plt.show()
Positional Encoding 값
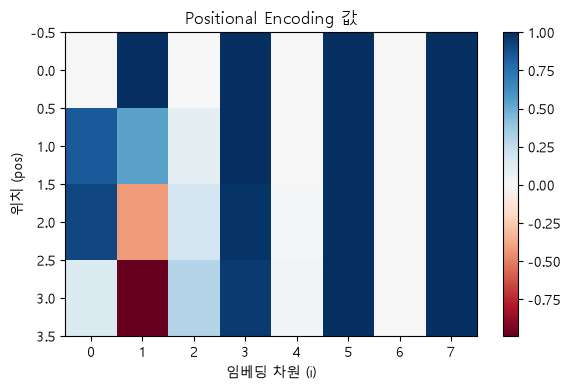
낮은 차원(왼쪽)일수록 위치에 따라 값이 빠르게 진동하고, 높은 차원(오른쪽)일수록 천천히 변합니다 — 여러 주기의 sin/cos 파형을 겹쳐서, 각 위치가 고유한 “지문”을 갖게 만드는 방식입니다.
실험: 순서를 섞으면 정말 결과가 달라질까
Positional Encoding이 없을 때는 토큰 순서를 뒤집어도(같은 토큰이 자리만 바꿔도) 그 토큰에 대한 self-attention 출력값은 그대로 자리만 옮겨갈 뿐 값 자체는 똑같습니다. Positional Encoding을 더하면 같은 토큰이라도 위치가 달라지면 출력이 달라지는지 직접 확인해봅니다.
def self_attention_np(X, Wq, Wk, Wv):
    Q, K, V = X @ Wq, X @ Wk, X @ Wv
    scores = (Q @ K.T) / np.sqrt(Wq.shape[1])
    weights = softmax(scores, axis=-1)
    return weights @ V

# 토큰 순서를 완전히 뒤집은 입력을 만든다 (같은 토큰들, 순서만 반대)
X_reordered = X[::-1].copy()

# Positional Encoding 없이 -> 같은 토큰(원래 0번, 뒤집으면 마지막 자리)의 출력이 똑같은지 확인
out_original = self_attention_np(X, Wq, Wk, Wv)
out_reordered = self_attention_np(X_reordered, Wq, Wk, Wv)
print("[PE 없음] 원래 0번 토큰 출력 == 뒤집었을 때 그 토큰의 출력?",
      np.allclose(out_original[0], out_reordered[-1]))

# Positional Encoding을 더한 뒤에는 같은 토큰이라도 위치가 다르면 결과가 달라지는지 확인
out_original_pe = self_attention_np(X + pe, Wq, Wk, Wv)
out_reordered_pe = self_attention_np(X_reordered + pe, Wq, Wk, Wv)
print("[PE 적용] 원래 0번 토큰 출력 == 뒤집었을 때 그 토큰의 출력?",
      np.allclose(out_original_pe[0], out_reordered_pe[-1]))
print("(PE 덕분에 '같은 토큰, 다른 위치'가 이제 다른 결과를 낸다는 뜻)")
실행 결과
[PE 없음] 원래 0번 토큰 출력 == 뒤집었을 때 그 토큰의 출력? True
[PE 적용] 원래 0번 토큰 출력 == 뒤집었을 때 그 토큰의 출력? False
(PE 덕분에 '같은 토큰, 다른 위치'가 이제 다른 결과를 낸다는 뜻)
이 실험이 Positional Encoding의 존재 이유를 가장 직접적으로 보여줍니다 — PE가 없으면 Self-Attention은 “집합(set)”만 보고, PE가 있어야 비로소 “순서가 있는 시퀀스”를 구별합니다.
12. Position-wise Feed-Forward Network
Self-Attention 다음에는 각 토큰에 똑같이, 독립적으로 적용되는 간단한 2층 MLP가 옵니다. \[\text{FFN}(x) = \max(0,\ xW_1 + b_1)W_2 + b_2\]
- 첫 번째 선형변환으로 차원을 확장 (
d_model→d_ff, 논문에서는 512 → 2048) - ReLU로 비선형성 추가
- 두 번째 선형변환으로 다시 원래 차원(
d_model)으로 축소
“Position-wise”라는 이름의 의미: 같은 FFN 가중치를 문장의 모든 위치(토큰)에 동일하게 적용합니다. Self-Attention이 “토큰들 사이의 관계”를 다뤘다면, FFN은 “각 토큰 자체를 한 번 더 가공”하는 역할입니다.
class PositionwiseFeedForward(nn.Module):
    def __init__(self, d_model, d_ff):
        super().__init__()
        self.linear1 = nn.Linear(d_model, d_ff)
        self.linear2 = nn.Linear(d_ff, d_model)

    def forward(self, x):
        return self.linear2(torch.relu(self.linear1(x)))

# 논문은 d_ff=2048(d_model=512의 4배)을 쓰는데, 우리 예제도 그 비율(4배)만 맞춘다
d_ff = d_model * 4
ffn = PositionwiseFeedForward(d_model=d_model, d_ff=d_ff)

test_out = ffn(x)  # x: 6번 섹션에서 만든 (1, seq_len, d_model) 텐서 재사용
print("FFN 입력 shape:", x.shape)
print("FFN 출력 shape:", test_out.shape)  # 입력과 동일한 shape 유지
실행 결과
FFN 입력 shape: torch.Size([1, 4, 8])
FFN 출력 shape: torch.Size([1, 4, 8])
13. Residual Connection과 Layer Normalization
레이어를 깊게 쌓을수록(논문은 6층) 학습이 불안정해지거나 정보가 손실되기 쉽습니다. 논문은 두 가지 장치로 이를 막습니다.
Residual Connection (잔차 연결)
서브레이어의 출력에 입력을 다시 더합니다. \[\text{output} = x + \text{Sublayer}(x)\]
서브레이어가 이상한 걸 배우더라도 최소한 원래 입력값(x)은 그대로 전달되니, 정보가 완전히 사라지지 않습니다. 레이어가 깊어져도 그래디언트가 잘 흐르게 해주는 핵심 장치입니다 (이미지 인식 모델 ResNet에서 가져온 아이디어).
Layer Normalization
각 토큰 벡터를 평균 0, 분산 1로 정규화해서 학습을 안정시킵니다.
논문의 공식은 이 둘을 항상 세트로 씁니다. \[\text{LayerNorm}(x + \text{Sublayer}(x))\]
“서브레이어 실행 → 잔차 연결 → 정규화” — Figure 1의 노란 “Add & Norm” 박스가 정확히 이것입니다.
# PyTorch에 이미 구현되어 있어서 그대로 가져다 쓰면 된다
layer_norm = nn.LayerNorm(d_model)

def add_and_norm(x, sublayer_output, norm):
    # "Add & Norm" 패턴을 함수로 만들어두면 앞으로 계속 재사용하기 편하다
    return norm(x + sublayer_output)

# 확인: Self-Attention을 통과시키고 Add & Norm 적용
attn_out, _ = attn(x)  # 6번 섹션에서 만든 SelfAttention 재사용
normed = add_and_norm(x, attn_out, layer_norm)

print("정규화 후 전체 평균(0에 가까워야 함):", normed.mean().item())
print("정규화 후 전체 표준편차(1에 가까워야 함):", normed.std().item())
실행 결과
정규화 후 전체 평균(0에 가까워야 함): -2.9802322387695312e-08
정규화 후 전체 표준편차(1에 가까워야 함): 1.0159950256347656
14. 하나로 합치기: EncoderLayer와 Encoder
지금까지 만든 조각들 — Multi-Head Attention, Position-wise FFN, Residual+LayerNorm — 을 합치면 논문 Figure 1의 왼쪽 절반(Encoder 한 층)이 완성됩니다.
Encoder 한 층의 순서:
- Multi-Head Self-Attention
- Add & Norm
- Position-wise Feed-Forward
- Add & Norm
이 한 층을 N=6번(논문 기준) 쌓은 것이 전체 Encoder입니다. 우리는 학습 규모를 줄여서 실습하지만, 구조는 논문과 동일합니다.
class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff):
        super().__init__()
        self.mha = ManualMultiHeadAttention(d_model, num_heads)
        self.ffn = PositionwiseFeedForward(d_model, d_ff)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)

    def forward(self, x):
        # 1) Multi-Head Self-Attention + Add & Norm
        attn_out, _ = self.mha(x)
        x = self.norm1(x + attn_out)

        # 2) Position-wise FFN + Add & Norm
        ffn_out = self.ffn(x)
        x = self.norm2(x + ffn_out)
        return x

class Encoder(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, num_layers):
        super().__init__()
        self.layers = nn.ModuleList([
            EncoderLayer(d_model, num_heads, d_ff) for _ in range(num_layers)
        ])

    def forward(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

torch.manual_seed(42)
# 논문은 N=6이지만, 실습이니 2층으로 축소
encoder = Encoder(d_model=d_model, num_heads=2, d_ff=d_ff, num_layers=2)
encoder_out = encoder(x)

print("Encoder 입력 shape:", x.shape)
print("Encoder 출력 shape:", encoder_out.shape)  # 입력과 완전히 동일한 shape
실행 결과
Encoder 입력 shape: torch.Size([1, 4, 8])
Encoder 출력 shape: torch.Size([1, 4, 8])
몇 층을 쌓든 입력과 출력의 shape이 완전히 동일하다는 점이 중요합니다 — 그래서 EncoderLayer를 원하는 만큼 반복해서 쌓을 수 있습니다.
15. Decoder 구조 맛보기
Encoder를 완성했으니, Decoder도 개념을 살펴봅니다. Decoder는 Encoder보다 서브레이어가 하나 더 많습니다 (Figure 1 오른쪽 절반).
- Masked Multi-Head Self-Attention — 8번 섹션에서 만든 Causal Mask를 여기서 씁니다. 디코더가 미래 단어를 못 보게 함
- Encoder-Decoder Attention (Cross-Attention) — Query는 디코더에서, Key/Value는 Encoder의 최종 출력에서 가져옵니다. “지금까지 만든 문장이 원문의 어느 부분과 관련있는지”를 찾는 역할
- Position-wise Feed-Forward — Encoder와 동일
각 서브레이어마다 Add & Norm이 붙는 것도 Encoder와 동일합니다.
Cross-Attention을 직접 구현해봅니다 — 우리가 만든 Self-Attention과 코드는 거의 같고, Q는 디코더 입력에서, K/V는 Encoder 출력에서 가져온다는 점만 다릅니다.
class CrossAttention(nn.Module):
    def __init__(self, d_model, d_k):
        super().__init__()
        self.d_k = d_k
        self.Wq = nn.Linear(d_model, d_k, bias=False)
        self.Wk = nn.Linear(d_model, d_k, bias=False)
        self.Wv = nn.Linear(d_model, d_k, bias=False)

    def forward(self, decoder_x, encoder_out):
        # Query는 디코더에서, Key/Value는 인코더 출력에서 가져온다
        Q = self.Wq(decoder_x)
        K = self.Wk(encoder_out)
        V = self.Wv(encoder_out)
        scores = Q @ K.transpose(-2, -1) / (self.d_k ** 0.5)
        weights = torch.softmax(scores, dim=-1)
        output = weights @ V
        return output, weights

class DecoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff):
        super().__init__()
        self.self_attn = SelfAttention(d_model, d_model)     # 1) Masked Self-Attention
        self.cross_attn = CrossAttention(d_model, d_model)   # 2) Encoder-Decoder Attention
        self.ffn = PositionwiseFeedForward(d_model, d_ff)    # 3) FFN
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)

    def forward(self, decoder_x, encoder_out, causal_mask):
        self_out, _ = self.self_attn(decoder_x, mask=causal_mask)
        decoder_x = self.norm1(decoder_x + self_out)

        cross_out, cross_weights = self.cross_attn(decoder_x, encoder_out)
        decoder_x = self.norm2(decoder_x + cross_out)

        ffn_out = self.ffn(decoder_x)
        decoder_x = self.norm3(decoder_x + ffn_out)
        return decoder_x, cross_weights

torch.manual_seed(42)
decoder_layer = DecoderLayer(d_model=d_model, num_heads=2, d_ff=d_ff)
decoder_input = torch.randn(1, seq_len, d_model)  # 디코더 쪽 입력(예: 번역 중인 문장)
causal_mask_dec = torch.tril(torch.ones(seq_len, seq_len)).bool()

decoder_out, cross_weights = decoder_layer(decoder_input, encoder_out, causal_mask_dec)
print("Decoder 출력 shape:", decoder_out.shape)
print("Cross-Attention 가중치 shape:", cross_weights.shape)  # (batch, decoder_seq, encoder_seq)
실행 결과
Decoder 출력 shape: torch.Size([1, 4, 8])
Cross-Attention 가중치 shape: torch.Size([1, 4, 4])
16. Embedding 스케일링과 Weight Tying
논문 3.4절에 나오는 두 가지 디테일입니다.
√d_model 스케일링
임베딩 벡터에 √d_model을 곱합니다. Positional Encoding은 대략 -1~1 범위의 값인데, 임베딩 값의 스케일이 이보다 훨씬 작으면 더해질 때 위치 정보에 파묻힐 수 있습니다. 스케일을 키워서 균형을 맞추는 장치입니다.
Weight Tying (가중치 공유)
입력 임베딩, 출력 임베딩, 그리고 마지막 출력층(단어 확률로 변환하는 Linear)이 같은 가중치 행렬을 공유합니다. “임베딩(단어→벡터)”과 “출력층(벡터→단어 확률)”은 사실 서로 역방향 변환이라, 같은 테이블을 쓰는 게 자연스럽다는 아이디어입니다. 파라미터 수도 줄어듭니다.
class TiedEmbedding(nn.Module):
    def __init__(self, vocab_size, d_model):
        super().__init__()
        self.d_model = d_model
        self.embedding = nn.Embedding(vocab_size, d_model)
        # 출력층을 따로 만들지 않고, 임베딩 테이블(가중치)을 그대로 전치해서 재사용한다

    def encode(self, token_ids):
        return self.embedding(token_ids) * (self.d_model ** 0.5)  # 논문의 √d_model 스케일링

    def decode_to_logits(self, x):
        # (batch, seq, d_model) @ (d_model, vocab_size) -> (batch, seq, vocab_size)
        # embedding.weight shape: (vocab_size, d_model) 이므로 전치해서 곱한다 (가중치 공유)
        return x @ self.embedding.weight.T

tied = TiedEmbedding(vocab_size=vocab_size9, d_model=d_model)  # 10번 섹션의 4단어 문장 재사용

scaled_emb = tied.encode(token_ids9)
logits = tied.decode_to_logits(scaled_emb)

print("공유 가중치로 만든 logits shape:", logits.shape)  # (1, seq_len, vocab_size)
print("임베딩 벡터 크기(스케일링 전) 평균:", tied.embedding(token_ids9).norm(dim=-1).mean().item())
print("임베딩 벡터 크기(스케일링 후) 평균:", scaled_emb.norm(dim=-1).mean().item())
print("스케일 비율(√d_model이어야 함):", d_model ** 0.5)
실행 결과
공유 가중치로 만든 logits shape: torch.Size([1, 4, 4])
임베딩 벡터 크기(스케일링 전) 평균: 2.537118911743164
임베딩 벡터 크기(스케일링 후) 평균: 7.176055431365967
스케일 비율(√d_model이어야 함): 2.8284271247461903
7.176 / 2.537 ≈ 2.828 = √8로, 스케일링이 정확히 의도한 대로 적용됐음을 확인할 수 있습니다.
17. Self-Attention을 쓰는 이유 (계산 복잡도 비교)
논문 4장은 Self-Attention을 RNN, CNN과 비교하며 왜 이 구조를 택했는지 설명합니다. n은 문장 길이, d는 임베딩 차원입니다.
| 레이어 종류 | 레이어당 계산량 | 순차 연산 횟수 | 최대 경로 길이 |
|---|---|---|---|
| Self-Attention | O(n² · d) | O(1) | O(1) |
| Recurrent (RNN) | O(n · d²) | O(n) | O(n) |
| Convolutional | O(k · n · d²) | O(1) | O(log_k(n)) |
(논문 Table 1을 재구성)
핵심 포인트 3가지
- 순차 연산 횟수(Sequential Operations): RNN은 토큰을 하나씩 순서대로 처리해야 해서
O(n). Self-Attention은 모든 토큰 쌍을 동시에(병렬로) 계산할 수 있어서O(1)— GPU 병렬처리에 훨씬 유리합니다. - 최대 경로 길이(Maximum Path Length): “문장의 첫 단어와 마지막 단어가 서로 영향을 주려면 정보가 몇 단계를 거쳐야 하는가”입니다. RNN은
O(n)(한 칸씩 전달해야 함)이라 문장이 길면 초반 정보가 희미해지기 쉽습니다(장기 의존성 문제). Self-Attention은 모든 토큰이 한 번의 연산으로 바로 서로를 볼 수 있어O(1)입니다. - 레이어당 계산량: Self-Attention은 문장이 아주 길어지면(
n이 커지면) 계산량이 제곱으로 늘어나는 단점이 있습니다(n²). 문장 길이n이 임베딩 차원d보다 작을 때 — 문장 번역처럼 일반적인 경우 — 는 오히려 RNN보다 유리합니다.
20번 섹션에서 보게 될 논문의 실제 시각화(Figure 3)에서, 멀리 떨어진 단어끼리 한 번의 attention 계산으로 바로 연결되는 걸 볼 수 있는데, 이게 바로 이 O(1) 최대 경로 길이가 실제로 드러난 모습입니다.
18. 논문처럼 학습 레시피 제대로 따라하기
10번 섹션에서는 그냥 고정된 학습률(lr=0.05)로 Adam을 썼습니다. 논문 5장은 훨씬 정교한 레시피를 씁니다. 세 가지를 우리 학습 코드에 추가해봅니다.
1) Warmup 학습률 스케줄
\[lrate = d_{model}^{-0.5} \cdot \min\left(step^{-0.5},\ step \cdot warmup\_steps^{-1.5}\right)\]처음 warmup_steps 동안은 학습률을 선형으로 증가시키고, 그 이후에는 역제곱근으로 서서히 감소시킵니다. 학습 초반에 너무 큰 학습률로 불안정해지는 걸 막고, 후반엔 세밀하게 수렴하게 합니다.
2) Dropout
서브레이어의 출력 중 일부를 랜덤하게 꺼서(0으로 만들어서) 과적합을 방지합니다. 논문은 P_drop=0.1을 씁니다.
3) Label Smoothing
정답 단어에 확률 1.0을 몰아주는 대신, 정답에는 0.9 정도만 주고 나머지 단어들에도 아주 조금씩(ε_ls=0.1을 분배) 확률을 남겨둡니다. 모델이 “너무 확신에 차지 않게” 만들어서 오히려 일반화 성능이 좋아진다고 합니다.
def warmup_lr(step_num, d_model, warmup_steps=10):
    step_num = max(step_num, 1)  # 0으로 나누기 방지
    return d_model ** -0.5 * min(step_num ** -0.5, step_num * warmup_steps ** -1.5)

steps = np.arange(1, 200)
lrs = [warmup_lr(s, d_model=d_model, warmup_steps=20) for s in steps]

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(steps, lrs, color="#F5A623", linewidth=2)
ax.axvline(20, color="gray", linestyle="--", linewidth=1, label="warmup_steps=20")
ax.set_xlabel("step")
ax.set_ylabel("learning rate")
ax.set_title("Warmup 학습률 스케줄")
ax.legend()
plt.tight_layout()
plt.show()
Warmup 학습률 스케줄
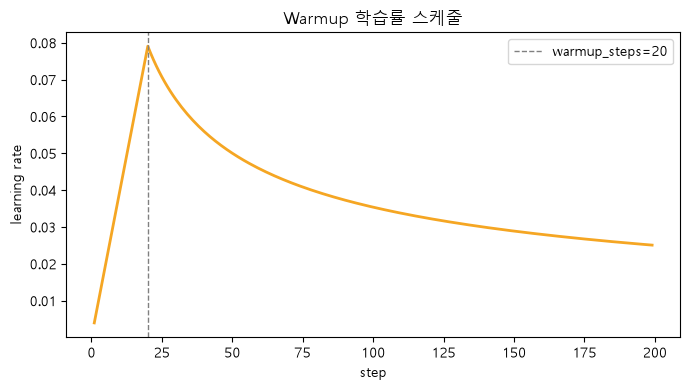
warmup_steps=20 지점에서 학습률이 정점을 찍고, 이후 완만하게 감소하는 곡선을 볼 수 있습니다.
class SelfAttentionWithDropout(nn.Module):
    # 10번 섹션 SelfAttention에 dropout만 추가한 버전
    def __init__(self, d_model, d_k, dropout=0.1):
        super().__init__()
        self.d_k = d_k
        self.Wq = nn.Linear(d_model, d_k, bias=False)
        self.Wk = nn.Linear(d_model, d_k, bias=False)
        self.Wv = nn.Linear(d_model, d_k, bias=False)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask=None):
        Q, K, V = self.Wq(x), self.Wk(x), self.Wv(x)
        scores = Q @ K.transpose(-2, -1) / (self.d_k ** 0.5)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, float("-inf"))
        weights = torch.softmax(scores, dim=-1)
        weights = self.dropout(weights)  # attention weight에도 dropout 적용 (논문 방식)
        output = weights @ V
        return output, weights

torch.manual_seed(0)
embedding10 = nn.Embedding(vocab_size9, d_model)
attn10 = SelfAttentionWithDropout(d_model=d_model, d_k=d_model, dropout=0.1)
output_head10 = nn.Linear(d_model, vocab_size9)

optimizer10 = optim.Adam(
    list(embedding10.parameters()) + list(attn10.parameters()) + list(output_head10.parameters()),
    lr=1.0,  # 실제 학습률은 매 스텝 스케줄러가 다시 정하므로 여기선 기준값 1.0으로 둔다
)
loss_fn_smooth = nn.CrossEntropyLoss(label_smoothing=0.1)  # Label Smoothing

warmup_steps = 20
loss_history10 = []
for step in range(1, 301):
    lr = warmup_lr(step, d_model=d_model, warmup_steps=warmup_steps)
    for g in optimizer10.param_groups:
        g["lr"] = lr

    x10 = embedding10(token_ids9)
    out10, _ = attn10(x10, mask=causal_mask9)
    logits10 = output_head10(out10)
    loss = loss_fn_smooth(logits10[:, :-1].reshape(-1, vocab_size9), targets9.reshape(-1))

    optimizer10.zero_grad()
    loss.backward()
    optimizer10.step()
    loss_history10.append(loss.item())

    if step % 50 == 0:
        print(f"step{step:3d}: lr={lr:.5f}, loss={loss.item():.4f}")

print("최종 loss:", loss_history10[-1])
print("(Label Smoothing 때문에 10번 섹션과 달리 loss가 정확히 0까지는 안 내려감 — 의도된 동작)")
실행 결과
step  50: lr=0.05000, loss=0.5411
step 100: lr=0.03536, loss=0.3489
step 150: lr=0.02887, loss=0.3490
step 200: lr=0.02500, loss=0.3488
step 250: lr=0.02236, loss=0.3489
step 300: lr=0.02041, loss=0.6539
최종 loss: 0.6539022326469421
(Label Smoothing 때문에 10번 섹션과 달리 loss가 정확히 0까지는 안 내려감 — 의도된 동작)
fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(loss_history, label="10번 섹션 (기본 Adam, lr 고정)", color="#6B7280")
ax.plot(loss_history10, label="18번 섹션 (Warmup + Dropout + Label Smoothing)", color="#F5A623")
ax.set_xlabel("epoch / step")
ax.set_ylabel("loss")
ax.set_title("학습 레시피 비교")
ax.legend()
plt.tight_layout()
plt.show()
학습 레시피 비교
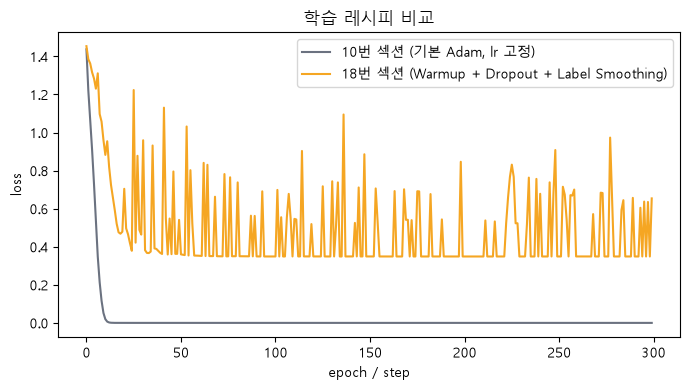
10번 섹션(회색)은 loss가 0까지 떨어지지만, 18번 섹션(주황)은 Label Smoothing 때문에 정답에 확률 1.0을 절대 주지 않아 loss가 어느 지점 아래로는 내려가지 않습니다 — 이건 버그가 아니라 “너무 확신하지 말라”는 의도된 정규화 효과입니다.
19. 실험 결과와 우리가 재현하지 않는 이유
논문 6장은 실제 기계번역 성능을 보고합니다.
| 모델 | EN→DE BLEU | EN→FR BLEU | 학습 비용(FLOPs) |
|---|---|---|---|
| GNMT + RL (RNN 기반, 이전 SOTA) | 24.6 | 39.92 | 2.3×10¹⁹ |
| ConvS2S (CNN 기반) | 25.16 | 40.46 | 9.6×10¹⁸ |
| Transformer (base) | 27.3 | 38.1 | 3.3×10¹⁸ |
| Transformer (big) | 28.4 | 41.8 | 2.3×10¹⁹ |
(논문 Table 2를 일부 재구성. BLEU는 기계번역 품질 점수로, 높을수록 좋음)
Transformer(base)가 이전 최고 성능 모델들보다 더 좋은 성능을, 훨씬 적은 학습 비용으로 달성했다는 게 핵심 결과입니다.
왜 이 노트북에서 재현하지 않는가
논문의 실제 학습 설정은 이렇습니다 (Table 3, 5장):
- 데이터: WMT 2014 영어-독일어 문장 450만 쌍
- 모델 크기:
d_model=512,d_ff=2048,h=8,N=6층(우리는d_model=8, 층 2개로 실습) - 하드웨어: 8개의 P100 GPU로 12시간~3.5일
이 노트북은 개념과 구조를 손으로 짚어보는 게 목적이라 문장 하나짜리 장난감 데이터로 실습했습니다. 지금까지 만든 코드(Encoder, Decoder, Positional Encoding, 학습 레시피)를 그대로 실제 규모(큰 데이터셋 + 큰 모델 + GPU 클러스터)로 키우면 원리상 논문과 같은 결과를 낼 수 있는 구조입니다 — 다만 그 실행에는 훨씬 큰 컴퓨팅 자원이 필요합니다.
하이퍼파라미터가 성능에 미치는 영향 (Table 3 요약)
- head 수를 1개로 줄이면 성능이 0.9 BLEU 떨어짐 → Multi-Head가 실제로 도움이 됨을 확인
- head를 너무 많이 늘려도(32개) 오히려 성능이 떨어짐 → head 수도 적절히 튜닝해야 하는 하이퍼파라미터
- 모델을 키울수록(층 수, 차원) 대체로 성능이 좋아지지만, Dropout 없이는 과적합됨
- 학습된 위치 임베딩과 sin/cos 방식의 성능 차이는 거의 없음 (11번 섹션에서 다룬 내용)
20. 진짜로 학습된 모델은 무엇에 주목할까
10/18번 섹션 실습은 단어 4개짜리 문장 하나만 외운 것이라, 실제 언어적 패턴을 학습했다고 보기는 어렵습니다. 논문은 실제로 WMT 데이터로 학습된 6층 모델의 attention을 시각화해서, 학습된 head들이 무엇에 주목하는지 보여줍니다 (Appendix).
장거리 의존성(Long-Distance Dependency) 포착
논문 Figure 3
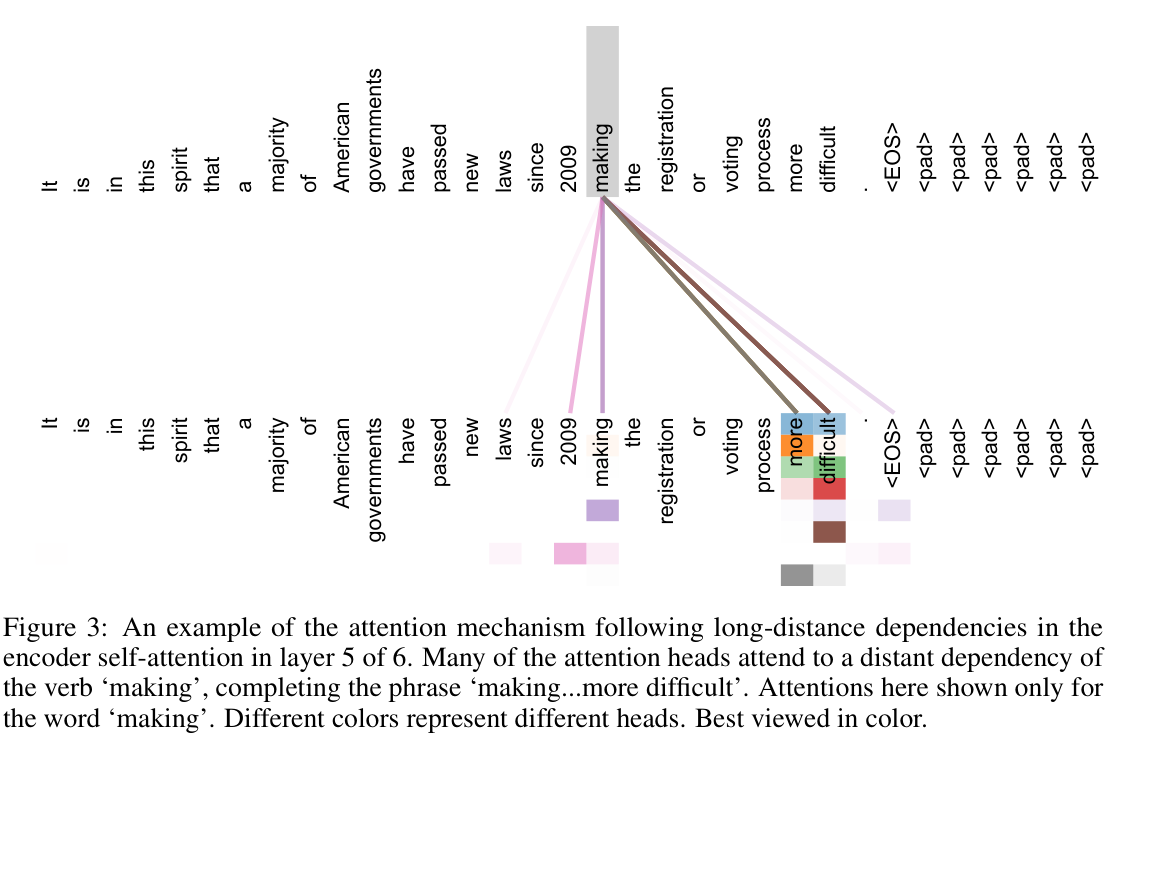
출처: Vaswani et al. (2017), Figure 3 (논문 permission에 따라 재수록).
문장 “…a majority of American governments have passed new laws since 2009 making … registration or voting process more difficult.” 에서, 동사 “making”의 attention이 훨씬 뒤에 있는 “more”, “difficult”로 이어지는 걸 볼 수 있습니다. “making … more difficult”라는 멀리 떨어진 구문 관계를, 중간 단어들을 다 거치지 않고 한 번의 attention 계산으로 바로 연결한 겁니다 — 17번 섹션에서 본 “최대 경로 길이 O(1)”의 실제 예시입니다.
대명사가 무엇을 가리키는지 찾기 (Anaphora Resolution)
논문 Figure 4 (Bottom 부분 발췌)
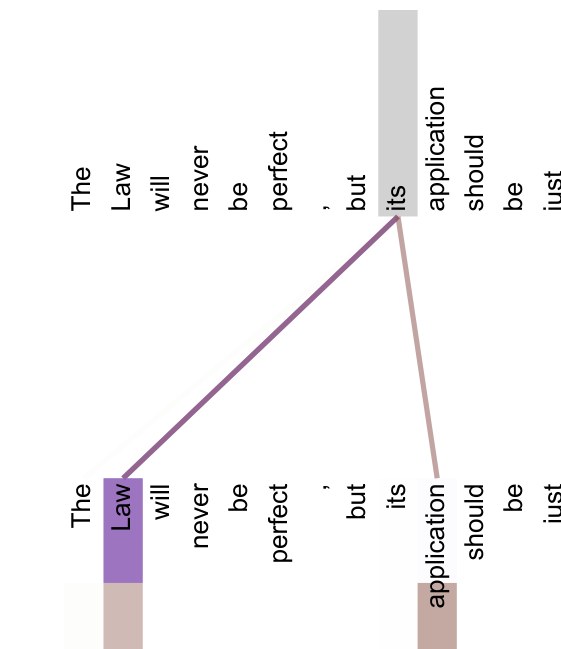
출처: Vaswani et al. (2017), Figure 4 Bottom 부분만 발췌 (논문 permission에 따라 재수록).
문장 “The Law will never be perfect, but its application should be just” 에서, 대명사 “its”의 attention이 “Law”와 “application”에 강하게 몰려 있습니다. “its”가 무엇을 가리키는지(Law) 사람이 문맥으로 파악하는 것과 비슷한 걸, 모델이 attention 가중치로 표현하고 있는 겁니다.
이런 패턴은 아무도 명시적으로 가르치지 않았습니다 — “다음 단어 맞히기(번역)” 과제만 반복 학습했을 뿐인데, 그 부산물로 문법적/의미적 구조를 스스로 익힌 것입니다. 2번 섹션에서 우리가 손으로 짜맞춘 “I”-“student” 예제가, 실제로는 이렇게 대규모 학습을 통해 자연스럽게 만들어진다는 걸 보여주는 실제 사례입니다.
21. 캡스톤: Positional Encoding까지 포함한 완전한 Encoder
마지막으로, 지금까지 만든 모든 조각을 다 이어서 논문 Figure 1의 왼쪽 절반(Encoder)을 완전히 재현해봅니다.
입력 문장 → 임베딩(+√d_model 스케일링) → Positional Encoding 더하기 → EncoderLayer × N → 최종 인코딩된 표현
class TransformerEncoder(nn.Module):
    def __init__(self, vocab_size, d_model, num_heads, d_ff, num_layers, max_len=50):
        super().__init__()
        self.d_model = d_model
        self.embedding = nn.Embedding(vocab_size, d_model)
        pe_table = positional_encoding(max_len, d_model)
        self.register_buffer("pe", torch.tensor(pe_table, dtype=torch.float32))
        self.layers = nn.ModuleList([
            EncoderLayer(d_model, num_heads, d_ff) for _ in range(num_layers)
        ])

    def forward(self, token_ids):
        seq_len = token_ids.shape[1]
        x = self.embedding(token_ids) * (self.d_model ** 0.5)    # 16번: √d_model 스케일링
        x = x + self.pe[:seq_len]                                 # 11번: Positional Encoding
        for layer in self.layers:                                # 14번: EncoderLayer × N
            x = layer(x)
        return x

torch.manual_seed(42)
full_encoder = TransformerEncoder(
    vocab_size=vocab_size9, d_model=d_model, num_heads=2, d_ff=d_ff, num_layers=2,
)

final_output = full_encoder(token_ids9)
print("최종 Encoder 출력 shape:", final_output.shape)
print(final_output[0].detach().numpy().round(3))

print("\n이 노트북에서 조립한 조각들:")
print("- Positional Encoding (11번)")
print("- Position-wise FFN (12번)")
print("- Residual + LayerNorm (13번)")
print("- Multi-Head Self-Attention (7번)")
print("=> 이 전부를 합친 EncoderLayer x N이 바로 지금 이 TransformerEncoder 입니다.")
실행 결과
최종 Encoder 출력 shape: torch.Size([1, 4, 8])
[[ 0.477  1.49   0.75  -1.295  1.071 -0.895 -0.587 -1.01 ]
 [-1.324  1.342 -0.304 -0.396  0.889  0.083 -1.441  1.151]
 [ 1.011 -1.209 -1.909  0.171 -0.121  0.906  0.161  0.991]
 [ 0.36  -0.489  0.196  1.361 -0.132  0.373 -2.282  0.613]]

이 노트북에서 조립한 조각들:
- Positional Encoding (11번)
- Position-wise FFN (12번)
- Residual + LayerNorm (13번)
- Multi-Head Self-Attention (7번)
=> 이 전부를 합친 EncoderLayer x N이 바로 지금 이 TransformerEncoder 입니다.
Part 1(Self-Attention 원리)에서 시작해서, Part 2에서 하나씩 채워온 조각들 — Positional Encoding, FFN, Residual/LayerNorm, Multi-Head Attention — 이 전부 이 한 클래스 안에 모였습니다. 이게 바로 논문 Figure 1의 Encoder를 코드로 완전히 재현한 것입니다.
연습 문제 및 해설
노트북에는 아래 12개 연습 문제에 대한 실제 풀이 코드와 실행 결과도 함께 들어있습니다. 직접 풀어본 뒤 비교해보세요.
연습 1. seq_len을 8개로 늘려서 실행하면?
np.random.seed(42)

seq_len = 8
d_model = 8

X = np.random.randn(seq_len, d_model)
d_k = d_model
Wq = np.random.randn(d_model, d_k)
Wk = np.random.randn(d_model, d_k)
Wv = np.random.randn(d_model, d_k)

Q, K, V = X @ Wq, X @ Wk, X @ Wv
scores = (Q @ K.T) / np.sqrt(d_k)
attn_weights = softmax(scores, axis=-1)
output = attn_weights @ V

print("attn_weights shape:", attn_weights.shape)  # (4,4) -> (8,8)로 커진 것 확인
실행 결과: attn_weights shape: (8, 8) — 토큰 개수(seq_len)의 제곱에 비례해서 attention weight 행렬이 커집니다. 이게 바로 17번 섹션에서 본 O(n²) 계산량입니다.
연습 2. √d_k로 나누지 않으면?
scores_unscaled = Q @ K.T                      # 스케일링 없음
scores_scaled = Q @ K.T / np.sqrt(d_k)          # 스케일링 있음

weights_unscaled = softmax(scores_unscaled, axis=-1)
weights_scaled = softmax(scores_scaled, axis=-1)

print("스케일링 없음 - 행별 최댓값:", weights_unscaled.max(axis=-1).round(3))
print("스케일링 있음 - 행별 최댓값:", weights_scaled.max(axis=-1).round(3))
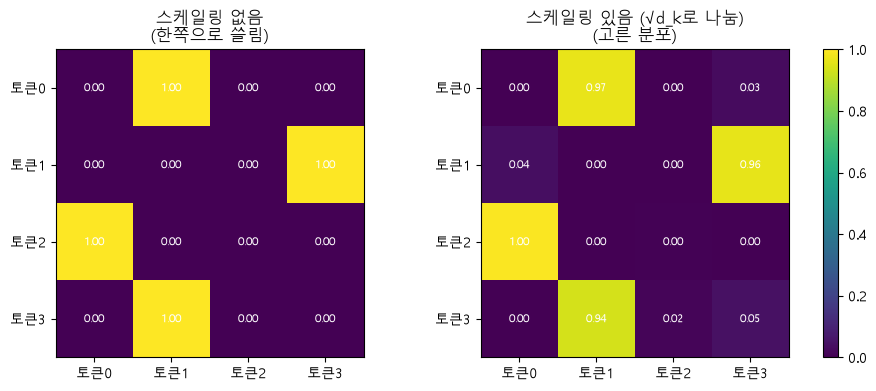
스케일링 유무 비교
실행 결과
스케일링 없음 - 행별 최댓값: [1. 1. 1. 1.]
스케일링 있음 - 행별 최댓값: [0.968 0.964 0.996 0.937]
스케일링이 없으면 각 행의 최댓값이 전부 1.0에 가깝게 나옵니다 — softmax가 한쪽으로 완전히 쏠려서(saturate) 사실상 argmax처럼 동작한다는 뜻입니다. 이렇게 되면 gradient가 거의 0이 되어 학습이 잘 안 됩니다. 2번 섹션에서 언급한 “\(\sqrt{d_k}\)로 나누는 이유”가 실제로 이렇게 나타납니다.
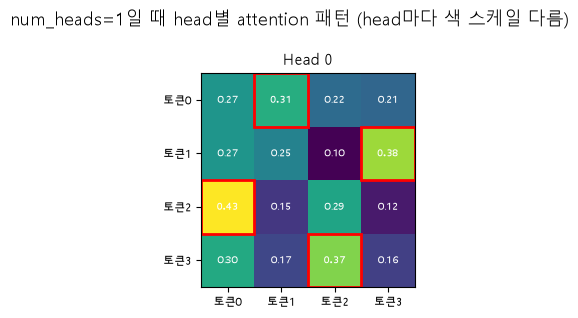
연습 3~4. num_heads를 1, 4, 8로 바꿔보면?
num_heads_list = [1, 4, 8]

for heads in num_heads_list:
    torch.manual_seed(42)
    manual_mha = ManualMultiHeadAttention(d_model=d_model, num_heads=heads)
    manual_out, manual_weights = manual_mha(x)
    print("[직접 구현] 가중치 shape:", manual_weights.shape)

    mha = nn.MultiheadAttention(embed_dim=d_model, num_heads=heads, batch_first=True)
    mha_out, mha_weights = mha(x, x, x)
    print("[내장 구현] 가중치 shape (기본: head 평균):", mha_weights.shape)
실행 결과 요약
| num_heads | 직접 구현 가중치 shape | 내장 구현 가중치 shape |
|---|---|---|
| 1 | (1, 1, 4, 4) | (1, 4, 4) |
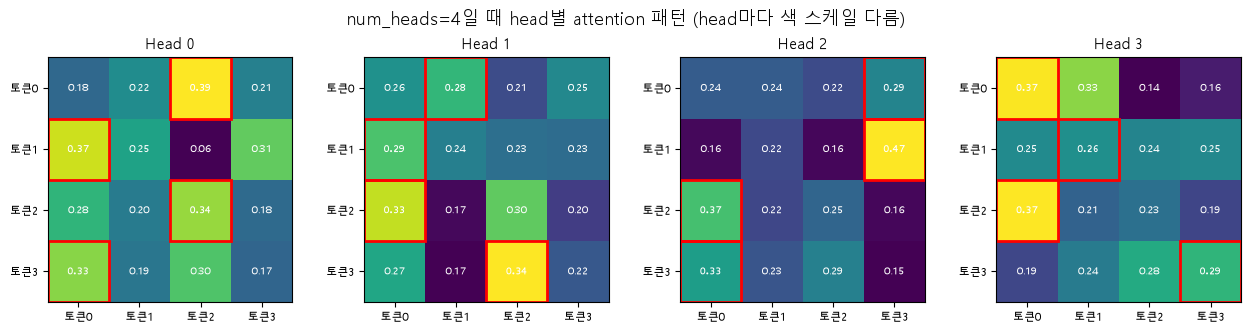
| 4 | (1, 4, 4, 4) | (1, 4, 4) |
| 8 | (1, 8, 4, 4) | (1, 4, 4) |
출력(out)의 shape은 head 수와 무관하게 항상 (1, 4, 8)로 동일하지만, head별 가중치는 num_heads만큼 늘어납니다. 내장 구현은 기본적으로 head 평균 하나만 돌려준다는 차이도 확인할 수 있습니다.
head마다 실제로 다른 곳을 보는지, 시각화와 함께 “Query 토큰별로 각 head가 가장 주목하는 Key 토큰”까지 뽑아본 것이 연습 4입니다.
num_heads=1일 때 head별 attention
num_heads=4일 때 head별 attention
num_heads=8일 때 head별 attention
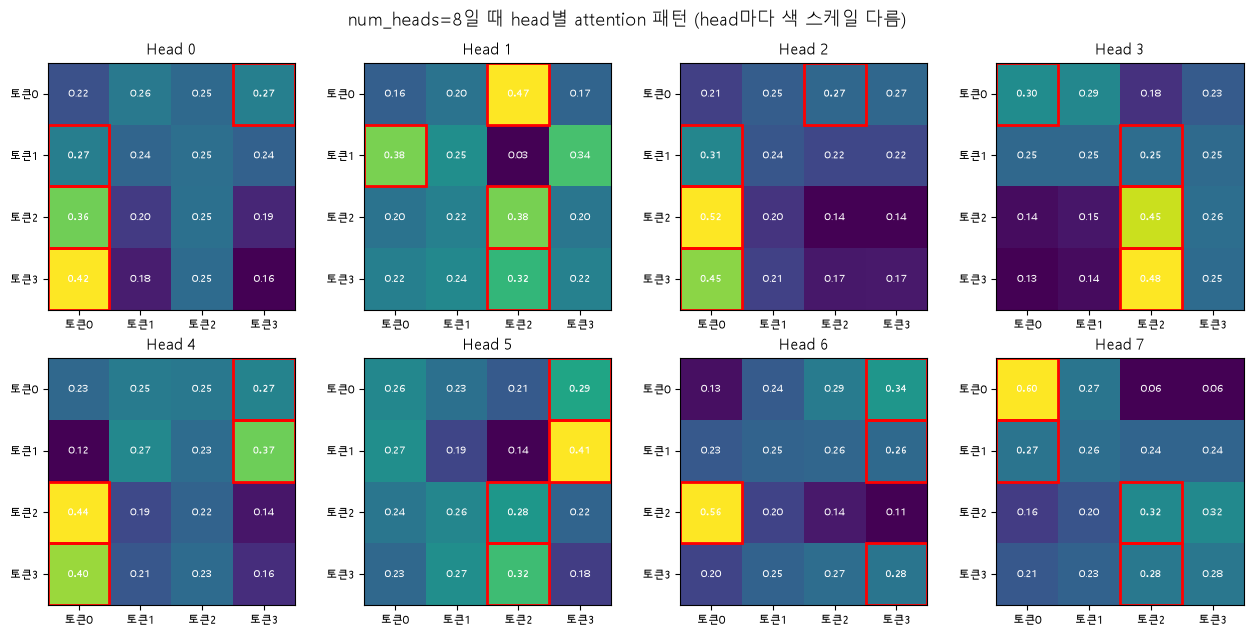
num_heads=8일 때의 결과를 보면, 같은 Query 토큰이라도 head마다 서로 다른 Key 토큰에 최댓값(빨간 테두리)이 찍힙니다.
토큰0: head0→토큰3, head1→토큰2, head2→토큰2, head3→토큰0, head4→토큰3, head5→토큰3, head6→토큰3, head7→토큰0
토큰1: head0→토큰0, head1→토큰0, head2→토큰0, head3→토큰2, head4→토큰3, head5→토큰3, head6→토큰3, head7→토큰0
토큰2: head0→토큰0, head1→토큰2, head2→토큰0, head3→토큰2, head4→토큰0, head5→토큰2, head6→토큰0, head7→토큰2
토큰3: head0→토큰0, head1→토큰2, head2→토큰0, head3→토큰2, head4→토큰0, head5→토큰2, head6→토큰3, head7→토큰2
head 개수가 늘어날수록 head별로 서로 다른 패턴이 더 뚜렷하게 갈라지는 걸 확인할 수 있습니다 (물론 이 모델은 학습되지 않은 상태라, 각 head가 “무엇을” 보는지에 의미를 부여하긴 어렵고 “서로 다른 곳을 본다”는 사실 자체가 중요합니다).
연습 5. Causal mask 유무에 따른 마지막 토큰의 attention
row_before = weights.squeeze(0)[3].detach().numpy()
row_after = weights_masked.squeeze(0)[3].detach().numpy()

print("토큰3 마스킹 전:", row_before.round(3))
print("토큰3 마스킹 후:", row_after.round(3))
print("완전히 동일한가?", np.allclose(row_before, row_after))
실행 결과
토큰3 마스킹 전: [0.172 0.268 0.367 0.193]
토큰3 마스킹 후: [0.172 0.268 0.367 0.193]
완전히 동일한가? True
마지막 토큰(토큰3)은 causal mask가 있어도 자기 자신을 포함해 모든 이전 토큰을 다 볼 수 있으므로(시퀀스의 끝이라 “미래”가 없음), 마스킹 전/후 값이 완전히 같습니다. 마스킹의 영향은 앞쪽 토큰일수록(볼 수 있는 범위가 좁을수록) 크게 나타납니다.
연습 6. RAG와 연결짓기 — Cross-Attention으로 확장
SelfAttention을 상속해서, Q와 K/V를 서로 다른 시퀀스에서 가져올 수 있도록 kv_x 인자를 추가했습니다. Q는 질문 문장에서, K/V는 검색된 문서에서 가져오면 이것이 곧 RAG의 retriever가 하던 일과 개념적으로 같습니다.
class CrossSelfAttention(SelfAttention):
    # 부모와 같은 파라미터 이름/순서(x, mask)를 유지하고, kv_x는 맨 뒤에 추가
    def forward(self, x, mask=None, kv_x=None):
        if kv_x is None:
            kv_x = x  # 안 주면 원래 SelfAttention과 동일하게 동작 (하위 호환)
        Q = self.Wq(x)
        K = self.Wk(kv_x)
        V = self.Wv(kv_x)
        scores = Q @ K.transpose(-2, -1) / (self.d_k ** 0.5)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, float("-inf"))
        weights = torch.softmax(scores, dim=-1)
        return weights @ V, weights

query_words = ["랭체인", "뭐야"]                              # 예: 질문
doc_words = ["랭체인", "은", "LLM", "쉽게", "다루는", "도구"]    # 예: 검색된 문서

query_embedding = nn.Embedding(len(query_words), d_model)
doc_embedding = nn.Embedding(len(doc_words), d_model)

query_x = query_embedding(torch.arange(len(query_words)).unsqueeze(0))
kv_x = doc_embedding(torch.arange(len(doc_words)).unsqueeze(0))

cross_attn = CrossSelfAttention(d_model=d_model, d_k=d_model)
out, weights = cross_attn(query_x, kv_x=kv_x)

print("출력 shape:", out.shape)        # (1, 2, 8)
print("가중치 shape:", weights.shape)  # (1, 2, 6)
실행 결과
출력 shape: torch.Size([1, 2, 8])
가중치 shape: torch.Size([1, 2, 6])
가중치 shape이 (1, 2, 6) — 질문 토큰 2개 × 문서 토큰 6개 — 로 나온다는 게 핵심입니다. Self-Attention에서 Q와 K/V의 출처만 분리했을 뿐인데, 곧바로 “질문이 문서의 어느 부분과 관련있는지”를 계산하는 Cross-Attention이 됩니다. RAG의 유사도 검색과 정확히 같은 발상입니다.
연습 7. num_epochs/lr을 바꾸면 수렴 속도가 어떻게 달라질까
lr을 0.01 / 0.05 / 0.10로 바꿔가며 300 epoch 학습을 반복한 결과, 학습률이 클수록 loss가 0에 훨씬 빨리 도달합니다.
lr=0.01: epoch 40부터 loss가 0.08 아래로 떨어지기 시작, epoch 100 이후 0.0004 부근에서 안정화
(10번 섹션의 lr=0.05 조건에서는 epoch 50 시점에 이미 loss가 0.0000으로 표시될 만큼 더 빠르게 수렴합니다.) 학습률이 너무 작으면 같은 epoch 수 안에 수렴하지 못하고, 너무 크면 (이 토이 예제 규모에서는 아니지만 일반적으로) 진동하거나 발산할 수 있다는 트레이드오프를 보여줍니다.
연습 8. PE 유무에 따라 “학습된 모델”의 순서 민감도가 달라질까
sentence9_reversed = sentence9[::-1]
reversed_ids = torch.tensor([[vocab9[w] for w in sentence9_reversed]])

with torch.no_grad():
    x_original = embedding9(token_ids9)
    x_reversed = embedding9(reversed_ids)

    out_original_noPE, _ = attn9(x_original)
    out_reversed_noPE, _ = attn9(x_reversed)
    same_noPE = torch.allclose(out_original_noPE[0, 0], out_reversed_noPE[0, -1], atol=1e-5)
    print("[학습된 모델, PE 없음] 같은 토큰(나는)의 출력이 자리만 바뀌어도 동일한가?", same_noPE)

    pe = torch.tensor(positional_encoding(len(sentence9), d_model), dtype=torch.float32)
    out_original_PE, _ = attn9(x_original + pe)
    out_reversed_PE, _ = attn9(x_reversed + pe)
    same_PE = torch.allclose(out_original_PE[0, 0], out_reversed_PE[0, -1], atol=1e-5)
    print("[학습된 모델, PE 적용] 이제는 동일한가?", same_PE)
실행 결과
원래 문장: ['나는', '오늘', '랭체인을', '공부한다']
뒤집은 문장: ['공부한다', '랭체인을', '오늘', '나는']
[학습된 모델, PE 없음] 같은 토큰(나는)의 출력이 자리만 바뀌어도 동일한가? True
[학습된 모델, PE 적용] 이제는 동일한가? False
11번 섹션에서 학습되지 않은 가중치로 확인했던 결론이, 학습이 끝난 모델에서도 그대로 성립한다는 걸 재확인했습니다.
연습 9. num_layers를 2 → 4 → 6으로 늘리면 파라미터 수는?
for n_layers in [2, 4, 6]:
    torch.manual_seed(42)
    encoder_test = Encoder(d_model=d_model, num_heads=2, d_ff=d_ff, num_layers=n_layers)
    out = encoder_test(x)
    num_params = sum(p.numel() for p in encoder_test.parameters())
    print(f"num_layers={n_layers}: 출력 shape={tuple(out.shape)}, 파라미터 수={num_params:,}")
실행 결과
num_layers=2: 출력 shape: (1, 4, 8), 파라미터 수: 1,680
num_layers=4: 출력 shape: (1, 4, 8), 파라미터 수: 3,360
num_layers=6: 출력 shape: (1, 4, 8), 파라미터 수: 5,040
출력 shape은 층 수와 무관하게 항상 동일하지만, 파라미터 수는 층 수에 정확히 비례합니다(2층=1,680 → 6층=5,040, 정확히 3배). EncoderLayer 하나가 독립적인 파라미터 세트를 가지므로 당연한 결과지만, 논문의 N=6이 실제로 얼마나 많은 파라미터를 필요로 하는지 감을 잡을 수 있습니다.
연습 10. warmup_steps를 5, 50, 200으로 바꾸면?
warmup_steps 비교
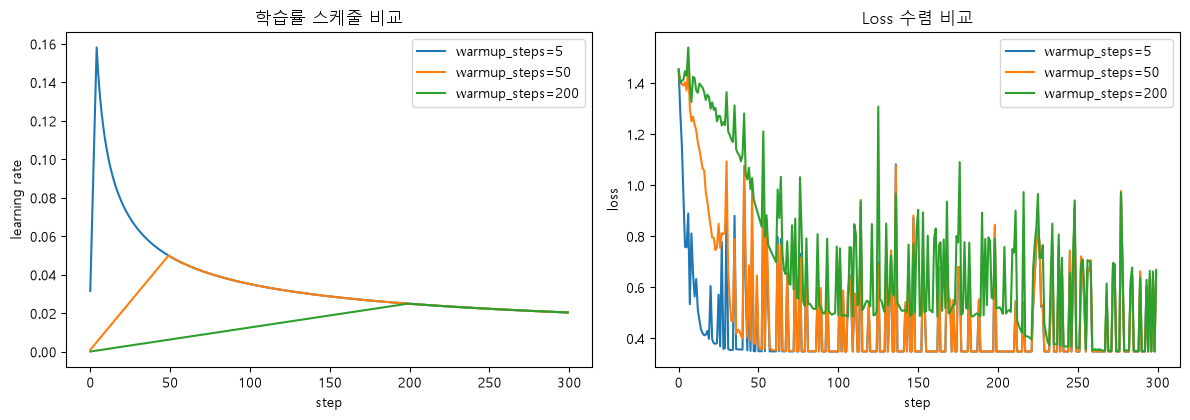
실행 결과
warmup_steps=5:   최고 lr=0.1581 (step 5),   최종 loss=0.6544
warmup_steps=50:  최고 lr=0.0500 (step 50),  최종 loss=0.6597
warmup_steps=200: 최고 lr=0.0250 (step 200), 최종 loss=0.6683
warmup_steps가 짧을수록 학습률이 더 높은 값까지 빠르게 치솟았다가 감소합니다. 이 토이 예제에서는 최종 loss 차이가 크지 않지만(0.65 근방으로 다 비슷), 실제 대규모 모델에서는 warmup_steps가 너무 짧으면 초반에 불안정해지고, 너무 길면 수렴이 느려지는 트레이드오프가 훨씬 크게 나타납니다.
연습 11. Label Smoothing 유무 비교
Label Smoothing 유무 비교
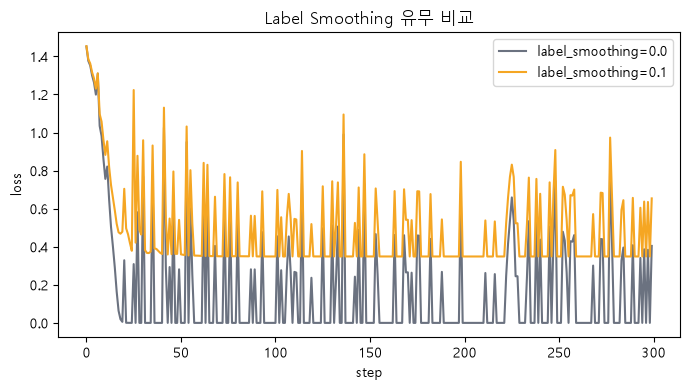
실행 결과
Label Smoothing 없음 - 최종 loss: 0.40432772040367126
Label Smoothing 있음 - 최종 loss: 0.6539022326469421
Label Smoothing이 없으면 loss가 더 낮은 값(0.404)까지 내려가는데, 이건 모델이 정답에 확률 1.0을 몰아주는 걸 그대로 허용하기 때문입니다. Label Smoothing이 있으면 정답에도 최대 0.9(=1-ε_ls)까지만 확률을 주도록 손실 함수 자체가 설계되어 있어서, loss가 구조적으로 더 높은 값(0.654)에서 바닥을 칩니다 — loss가 더 높다고 성능이 나쁜 게 아니라,애초에 도달 가능한 최솟값 자체가 다르다는 점이 포인트입니다.
연습 12. Cross-Attention에 다른 원문을 넣으면?
DecoderLayer는 그대로 두고, encoder_out만 서로 다른 두 문장(sentence_A, sentence_B)을 인코딩한 결과로 바꿔서 비교합니다.
sentence_A = ["나는", "오늘", "랭체인을", "공부한다"]
sentence_B = ["오늘", "날씨가", "정말", "좋다"]

encoder_out_A = encoder(src_embedding(ids_A))
encoder_out_B = encoder(src_embedding(ids_B))

out_with_A, cross_w_A = decoder_layer(decoder_input, encoder_out_A, causal_mask_dec)
out_with_B, cross_w_B = decoder_layer(decoder_input, encoder_out_B, causal_mask_dec)

print("decoder_out 완전히 동일한가?", torch.allclose(out_with_A, out_with_B))
print("두 출력의 차이(절댓값 평균):", (out_with_A - out_with_B).abs().mean().item())
실행 결과
decoder_out 완전히 동일한가? False
두 출력의 차이(절댓값 평균): 0.13363191485404968

cross_weights (원문 A):
[[0.27 0.23 0.3  0.21]
 [0.28 0.1  0.19 0.42]]

cross_weights (원문 B):
[[0.24 0.28 0.24 0.23]
 [0.11 0.36 0.21 0.32]]
디코더 쪽 입력(decoder_input)은 완전히 동일했는데도, Cross-Attention이 참고하는 encoder_out만 바뀌었을 뿐인데 디코더 출력이 달라졌습니다. 이것이 바로 실제 번역 모델에서 “같은 디코더 상태라도 원문이 다르면 다른 것에 주목하고, 결국 다른 단어를 생성한다”는 Cross-Attention의 핵심 동작입니다.
참고자료
원 논문
- Vaswani et al., “Attention Is All You Need” (2017), arXiv:1706.03762 — 이 강의노트 Part 2(11~21번)의 기준이 된 논문입니다.
- 논문에 실린 그림(Figure 1, 2, 3, 4)은 논문 1페이지에 명시된 저작권 안내 “Provided proper attribution is provided, Google hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works.”에 따라, 출처를 밝히고 학습 목적으로 재수록했습니다.
개념 설명 블로그 (Part 1)
이 강의노트의 배경 설명(Attention, Self-Attention, Multi-Head Attention 개념)은 아래 “초등학생도 이해하는 자연어처리” 시리즈를 참고해 재구성했습니다. 코드 없이 개념 위주로 더 쉽게 풀어 쓴 글이라, 개념이 헷갈릴 때 같이 보면 좋습니다.